Содержание
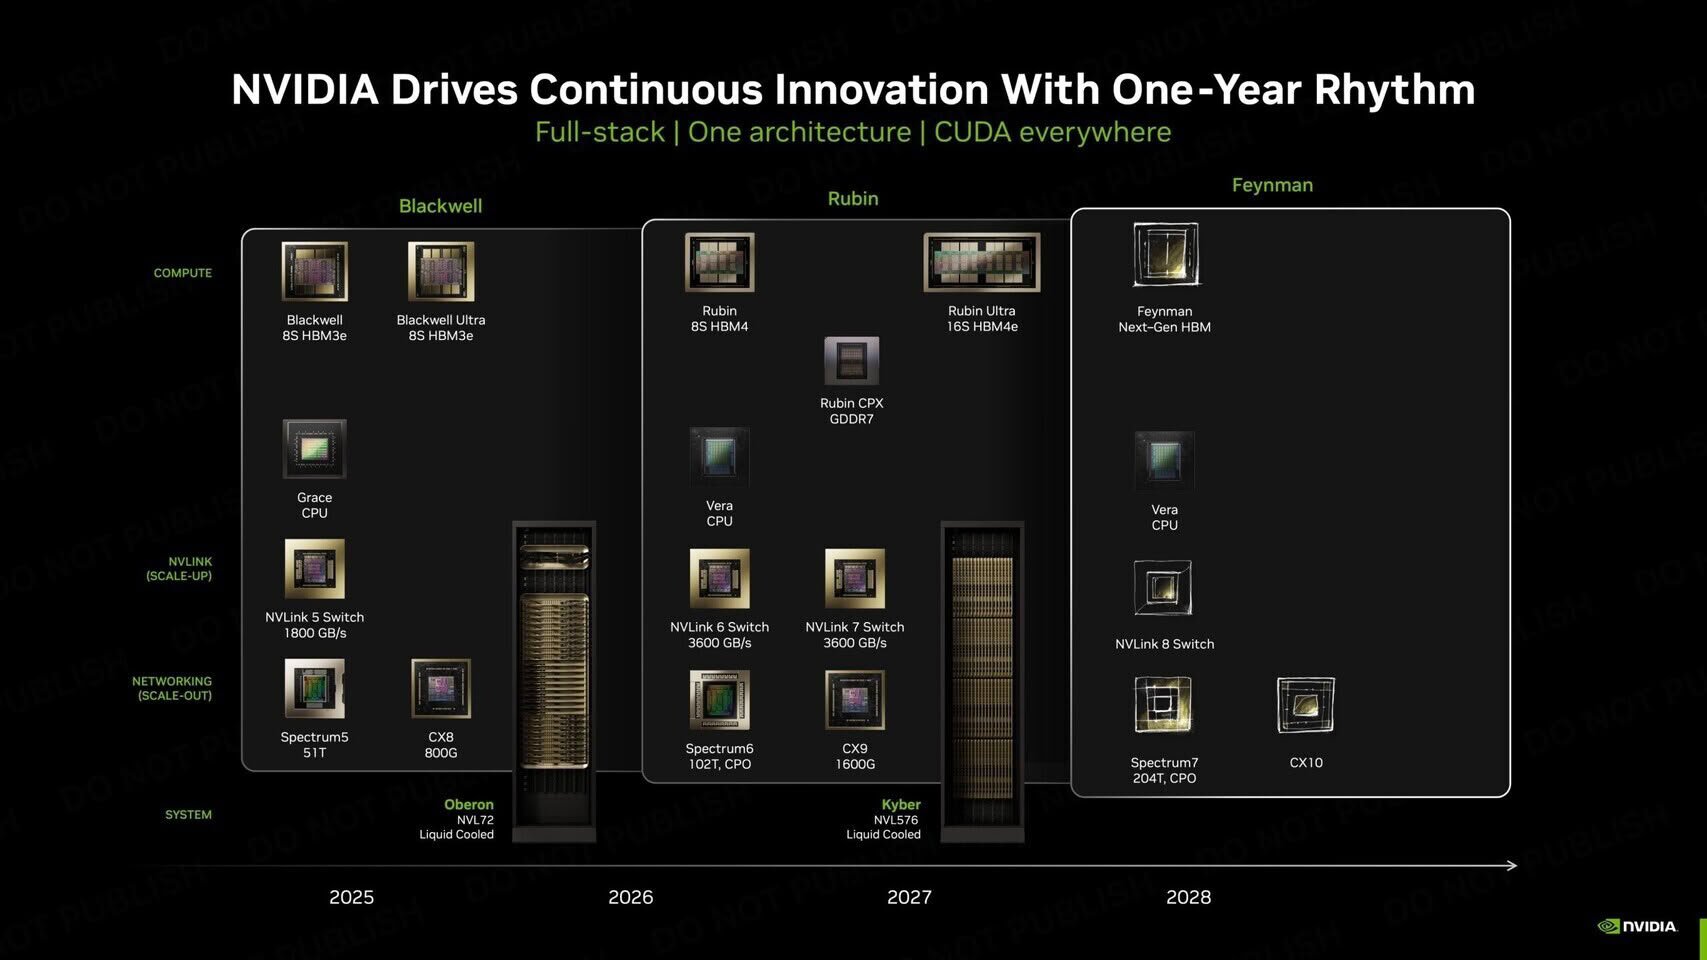
NVIDIA Feynman, следующая GPU-архитектура после Rubin и Rubin Ultra, может сразу перейти на TSMC A16. DigiTimes пишет, что NVIDIA уже работает над прототипами и пропустит семейство N2.
Если отчет верен, компания выбирает не промежуточный 2-нм класс, а более плотный техпроцесс 1,6 нм A16. Массовое производство таких GPU в цепочке поставок привязывают ко второй половине 2028 года.
Для домашнего ПК это пока не история про RTX 6090 в соседнем магазине. Речь идет о серверных ускорителях для ИИ-кластеров. Но именно там NVIDIA обкатывает упаковку, память и межсоединения, которые потом влияют на всю линейку.
TSMC A16 даёт NVIDIA питание с обратной стороны кристалла
Главная ставка в A16 — питание с обратной стороны кристалла. Логика простая: линии питания уводят на заднюю сторону, а фронтальная часть остаётся для сигнальных дорожек. На таких плотностях каждый миллиметр трассировки уже влияет на частоты, нагрев и задержки.
NVIDIA, по данным DigiTimes, не хочет заходить в семейство N2 для Feynman. Компания сразу нацелилась на A16, где TSMC должна совместить новый узел с продвинутой упаковкой.
- SoIC: 3D-стекинг нескольких чиплетов в одном корпусе.
- CoWoS-L: 2,5D-интеграция чипов рядом друг с другом.
- CoPoS: вариант упаковки для крупных многочиповых систем.
- Panel-level packaging: упаковка следующего поколения на больших панелях.
SoIC нужен, чтобы поставить чиплеты ближе друг к другу. Чем короче путь сигнала между блоками, тем ниже задержка. Потом такие 3D-сборки разместят бок о бок через CoWoS-L или CoPoS.
И масштаб тут серверный. В отчете упоминаются много-киловаттные конструкции, которые смогут считать десятки PetaFLOPS. Для сравнения: обычная видеокарта в игровом ПК живёт в пределах сотен ватт, а не киловатт на узел.
Feynman получит кастомную HBM, вероятно HBM4E
Память для Feynman тоже не выглядит стандартной. NVIDIA будет работать с партнёрами над кастомной HBM, и к запуску архитектуры речь, вероятно, пойдет о HBM4E.
Самая любопытная часть — базовый кристалл памяти. В него могут добавить логику: контроллер памяти или блок обработки пакетов. Такой слой сможет частично готовить данные до обращения к массивам памяти.
Это похоже на попытку разгрузить GPU от мелкой служебной работы. Не магия и не бесплатная производительность, а ещё один способ сократить простои вычислительных блоков. В ИИ-нагрузках память и обмен данными часто ограничивают систему не меньше, чем сами ядра.
Оптические соединения должны вывести стойки за 1000 ТБ/с
Следующий потолок для NVIDIA — не только чипы, но и связь между ними. Медные соединения хорошо знакомы индустрии, но на уровне целых стоек они упираются в задержки и энергопотребление.
Для Feynman в отчете указаны co-packaged optics, то есть оптические межсоединения прямо рядом с вычислительными чипами. NVIDIA должна использовать технологию TSMC COUPE, чтобы связать GPU светом, а не только медью.
| Поколение | Суммарная пропускная способность между GPU |
|---|---|
| Blackwell NVL72 | 130 ТБ/с |
| Rubin | 260 ТБ/с |
| Rubin Ultra | 520 ТБ/с |
| Feynman | более 1000 ТБ/с |
Рост хорошо видно по стойкам. Blackwell NVL72 уже даёт 130 ТБ/с между GPU. Rubin удваивает планку до 260 ТБ/с, Rubin Ultra — до 520 ТБ/с. Для Feynman планируют перейти в зону свыше 1000 ТБ/с, то есть в петабайтный диапазон.
Официального анонса Feynman от NVIDIA пока нет. Вся конкретика сейчас держится на отчете DigiTimes и данных цепочки поставок. Серийное производство Feynman в этих данных привязано ко второй половине 2028 года.