Содержание
Nvidia Rubin CPX снова появился в дорожной карте компании: ускоритель для ИИ, по данным аналитика Мин-Чи Куо, перевели с 128 ГБ GDDR7 на 168 ГБ HBM4.
Это не игровая видеокарта и не замена RTX. Rubin CPX нужен для серверных стоек, где крутятся большие языковые модели. Причем Nvidia разводит задачи по разным GPU: CPX берет на себя prefill, а обычные Rubin отвечают за decode.
Rubin CPX сменил память и вернулся после паузы
Nvidia еще в конце 2025 года говорила о специализированном ускорителе на базе семейства Rubin. Его готовили под крупные agentic AI-нагрузки. Затем проект, по данным цепочки поставок, поставили на паузу. Теперь компания переработала память и упаковку чипа.
Главное изменение — отказ от GDDR7. Ранняя версия Rubin CPX должна была получить 128 ГБ GDDR7. Новая конфигурация использует 168 ГБ HBM4. Для серверного ИИ это логичный, но дорогой поворот: таким задачам важна не только емкость, но и пропускная способность памяти.
| Параметр | Ранний Rubin CPX | Новый Rubin CPX |
|---|---|---|
| Память | 128 ГБ GDDR7 | 168 ГБ HBM4 |
| Упаковка | без интеграции HBM4 | вероятно TSMC CoWoS-S или CoWoS-L |
| Роль | ускоритель prefill | ускоритель prefill и KV cache |
Переход на HBM4 меняет не только спецификации на бумаге. Nvidia пришлось переделать корпусирование кристалла. Куо указывает на вероятное применение TSMC CoWoS-S или CoWoS-L. Это не финальная спецификация от Nvidia, а оценка по цепочке поставок.
Prefill и decode разделили между разными стойками
Rubin CPX нужен для prefill-нагрузок: он обрабатывает входной контекст модели и связанный KV cache. Decode при этом уходит на обычные Rubin GPU. Такой подход полезен для LLM с длинным контекстом, где подготовка входных данных быстро забивает память и шину.
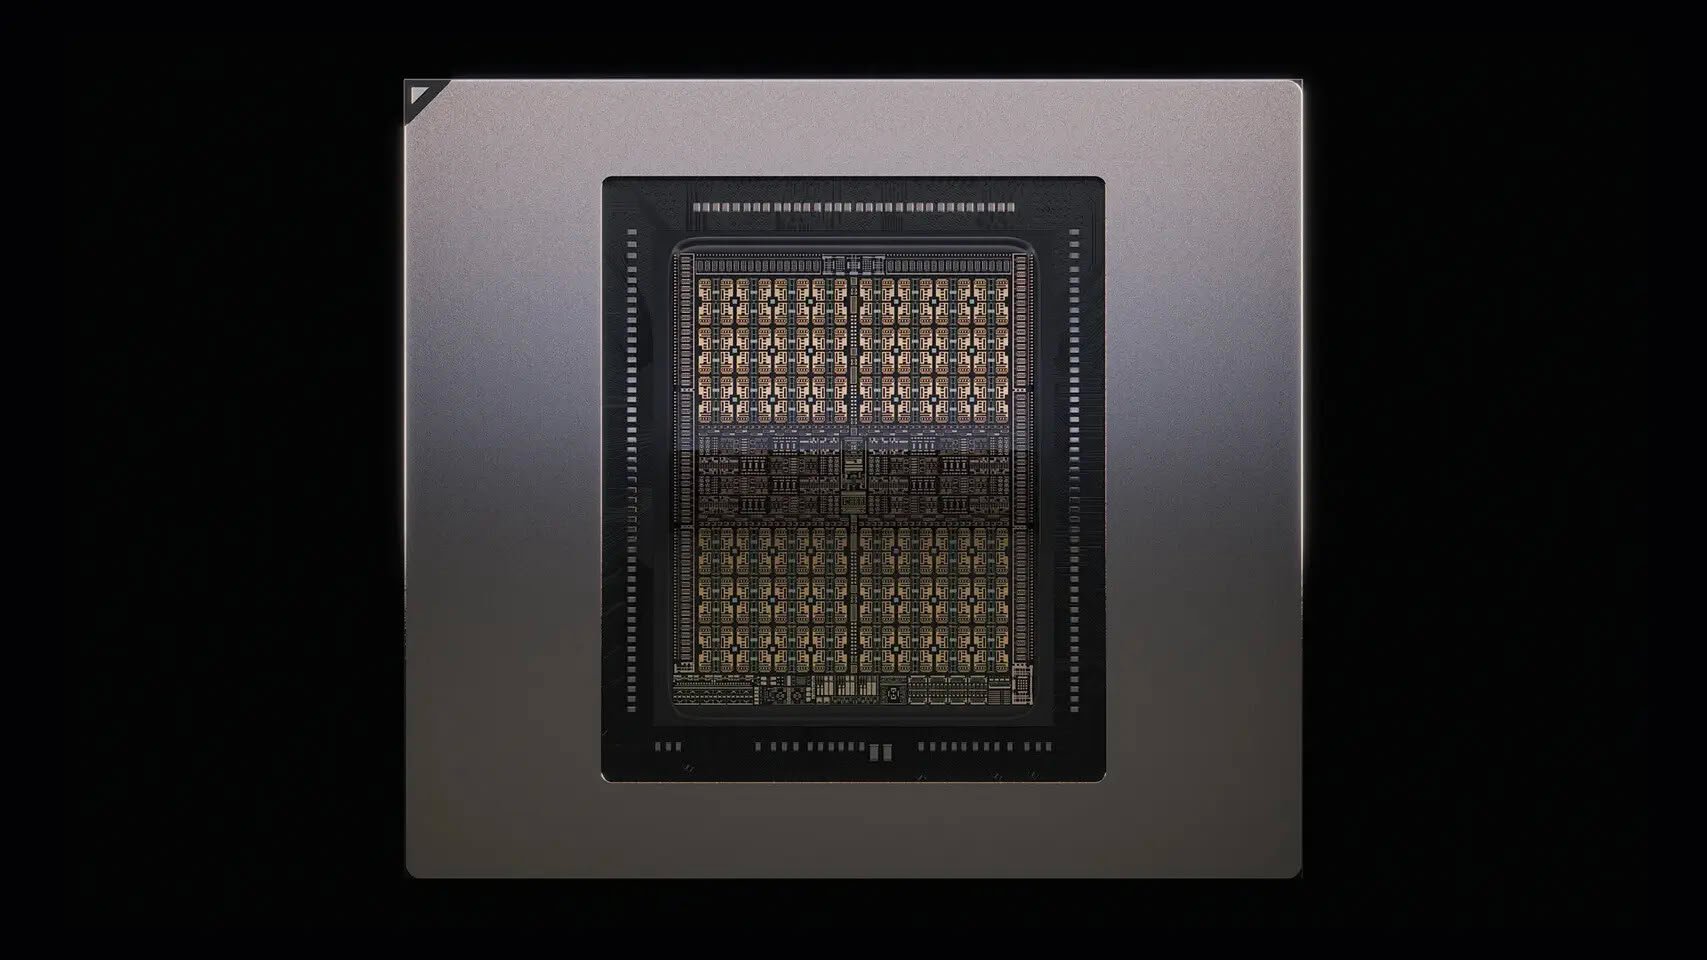
Если объяснять по-простому, prefill — это момент, когда модель переваривает ваш запрос, документы и историю диалога. Decode — генерация новых токенов после этой подготовки. В больших системах эти стадии требуют разного баланса вычислений и памяти.
Одна tray-полка с восемью CPX GPU, по данным Куо, тянет 1,34 ТБ long-context prefill вместе с KV cache. В стойках Nvidia планирует от 64 до 256 отдельных CPX GPU. Это уже уровень дата-центров, а не лабораторной машины под столом.
- Назначение: prefill для LLM и обработка KV cache
- Память: 168 ГБ HBM4 на GPU
- Стойка: от 64 до 256 CPX GPU
- Tray: 8 CPX GPU и 1,34 ТБ long-context prefill
Nvidia также рекомендует соотношение 1:1 между CPX GPU и обычными Rubin GPU в decode-стойке. То есть один отдельный парк ускорителей готовит контекст, второй генерирует ответ. Для провайдеров ИИ это вопрос задержки и цены каждого токена.
30 PFLOPS NVFP4 и встроенные NVENC/NVDEC
Rubin CPX, по опубликованным данным, использует монолитный кристалл и выдает 30 PFLOPS в формате NVFP4. Это низкоточный формат для ИИ-вычислений, где важны плотность операций и энергоэффективность, а не классическая точность FP32 из игровых бенчмарков.
На кристалл также вынесли четыре NVENC и четыре NVDEC. Эти блоки кодируют и декодируют видео без внешних ускорителей. Для мультимодальных пайплайнов это практично: видео, изображения и текст все чаще встречаются в одной серверной задаче.
Здесь нет смысла сравнивать Rubin CPX с GeForce по FPS. Ускоритель проектируют для стоек, которые обслуживают модели с триллионами параметров. И главный ресурс там — память рядом с кристаллом, плюс быстрый обмен данными между стадиями запроса.
Пока Nvidia не раскрыла цену Rubin CPX, сроки поставок и финальные конфигурации серверов. Из конкретных дат в этой новости есть только публикация Куо от 1 сентября 2026 года; официального пресс-релиза Nvidia по обновленной версии CPX пока нет.