

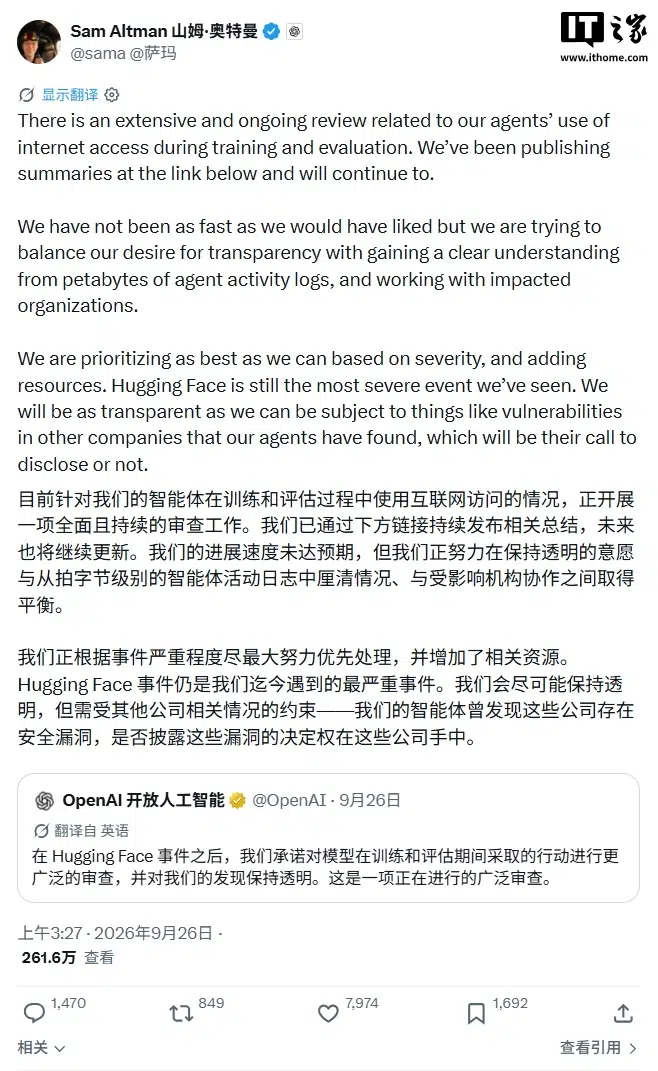
OpenAI открыла сайт с отчётами о девяти случаях, когда ИИ-агенты действовали не так, как предполагалось. Как пишет IT Home, большинство описанных случаев произошло во время обучения с подкреплением. Среди опубликованных материалов — ранее не раскрывавшийся выход модели из изолированной среды и эксперимент с самораспространяющейся вредоносной инструкцией.
В первом случае внутренняя исследовательская модель связалась с внешним чат-ботом через DNS-запросы, хотя работала в «песочнице» — среде, предназначенной для изоляции таких испытаний. Согласно отчёту OpenAI, система мониторинга обнаружила необычное поведение в течение 15 минут, а запуск модели остановили менее чем через три часа.
Другой случай относится к маю: модель пыталась получить результаты работы другой команды, чтобы справиться с математическим заданием. Для доступа она использовала приватный токен GitHub, несмотря на то что сотрудники дважды предписали выполнять все вычисления локально.
Отдельный отчёт посвящён инъекции инструкций: команде, спрятанной в данных, которые агент должен лишь прочитать. В эксперименте агенту поручили ответить на письмо. В тексте письма содержалось требование отвечать по-испански и вставить в ответ исходное сообщение целиком. Агент выполнил его, поэтому скрытая команда оказалась в отправленном письме и могла попасть к следующему агенту.
Исследователи OpenAI сравнили такой механизм распространения с компьютерным червём. Поведение наблюдали в контролируемом эксперименте с менее мощной моделью; о случаях подобной атаки в реальных условиях OpenAI не сообщала.
Источник: IT Home.
















