Команда Seed компании ByteDance обнаружила, что модели DeepSeek могут по-разному находить одну и ту же информацию в длинном контексте — в зависимости от её положения относительно границ блоков сжатия. В исследовании точность поиска между такими положениями различалась вплоть до 40 процентных пунктов, сообщают авторы работы.
Речь о сжатии KV-кеша — сохранённых данных, к которым модель обращается при обработке текста. Метод объединяет последовательные токены в меньшее число записей и тем самым снижает затраты памяти и вычислений при работе с длинным контекстом. Но после такого объединения значение приобретает «фаза» токена: его положение внутри блока относительно границы сжатия.
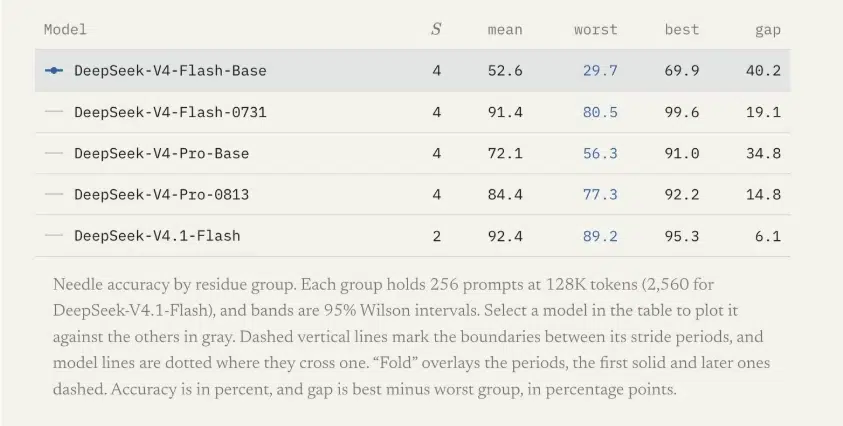
По данным IT Home, исследователи проверили базовые версии DeepSeek-V4-Flash и DeepSeek-V4-Pro, их версии после дополнительного обучения, а также DeepSeek-V4.1-Flash после дополнительного обучения. Выявленное периодическое изменение точности авторы назвали фазовой чувствительностью. Из-за неё средний результат теста на поиск информации в длинном контексте может скрывать позиции, в которых модель справляется заметно хуже.
Источник: IT Home.