

Содержание
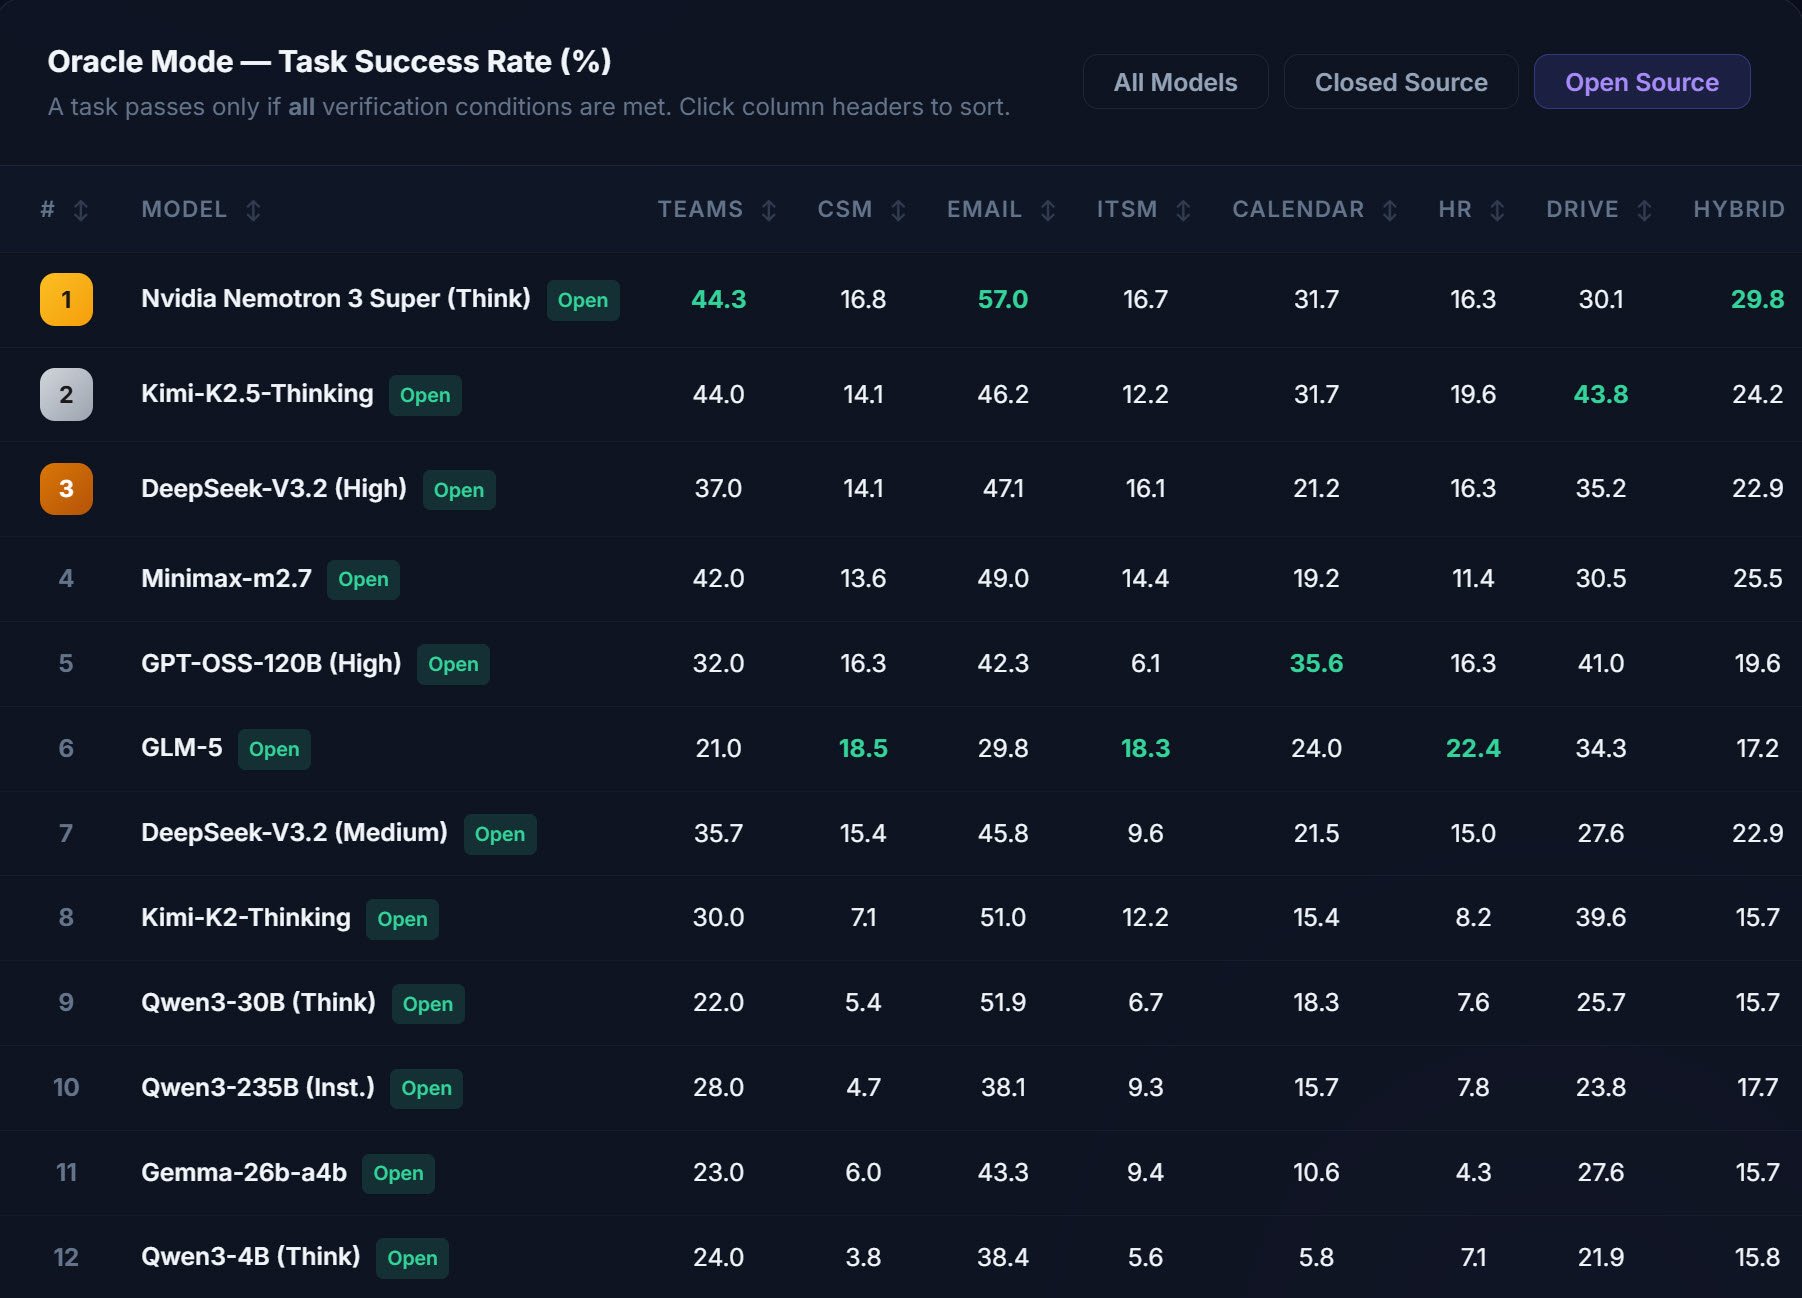
Nvidia вывела свою open-source модель Nemotron 3 Super в лидеры таблицы EnterpriseOps-Gym. В свежих результатах бенчмарка модель набрала 27,3 балла в среднем и обошла Kimi-K2.5 и DeepSeek v3.2 среди открытых решений.
Речь про корпоративный агентный бенчмарк, где модели решают задачи не в вакууме, а в интерактивных средах. Там нужно дергать инструменты и доводить workflow до конца, как в реальных энтерпрайз-системах.
EnterpriseOps-Gym проверяет агентные модели на 1 150 задачах
EnterpriseOps-Gym оценивает модели на 1 150 задачах в полностью интерактивных окружениях и с доступом к 512 функциональным инструментам. По описанию бенчмарка, агентам приходится координировать действия между несколькими корпоративными системами и тулзами, чтобы закрыть один бизнес-процесс.
Это важная оговорка: такие тесты меньше про «красивый текст», и больше про то, как модель ведет себя в цепочках действий. Ошибся на шаге — и весь сценарий разваливается.
Текущий лидер open-source части таблицы — Nemotron 3 Super с 27,3 балла. По разбивке сценариев модель лидирует в TEAMS, Email и Hybrid workflows. В категориях CSM, ITSM и Drive она остается конкурентоспособной, но без заявленного лидерства.
Из ближайших преследователей: Kimi-K2.5 идет на втором месте, DeepSeek v3.2 — на третьем. GPT-OSS-120B в этом рейтинге стоит на пятой позиции.
Сама таблица доступна публично на сайте проекта: EnterpriseOps-Gym leaderboard.
Что именно Nvidia вложила в Nemotron 3 Super
Nemotron 3 Super Nvidia представила в марте этого года. Это модель класса 120B, но с 12B активных параметров и гибридной архитектурой MoE (mixture of experts). Компания заявляет 5x throughput по сравнению с предыдущей Nemotron Super.
Отдельный акцент — контекст. У Nemotron 3 Super заявлено нативное окно 1M токенов, которое Nvidia подает как базу для «долгой памяти» агентных сценариев и более точного, согласованного рассуждения.
- Latent MoE: модель вызывает в 4 раза больше «экспертов» при той же стоимости инференса за счет сжатия токенов до попадания к экспертам.
- Multi-token prediction (MTP): предсказывает несколько будущих токенов за один forward pass, чтобы ускорять генерацию длинных последовательностей и дать встроенный speculative decoding.
- Hybrid Mamba-Transformer: бэкбон сочетает слои Mamba для эффективности на последовательностях и Transformer-слои для точного reasoning. Nvidia заявляет 4-кратное улучшение эффективности по памяти и вычислениям.
- NVFP4 pretraining: предобучение в NVFP4 с оптимизацией под Blackwell. Nvidia говорит о 4-кратном ускорении инференса на B200 по сравнению с FP8 на H100 при сохранении точности.
- RL пост-тренировка: обучение с reinforcement learning в 21 конфигурации окружений через NeMo Gym и NeMo RL, с более чем 1,2 млн rollout-эпизодов.
Почему это похоже на демонстрацию «полного стека» Nvidia
В этой истории важен не только результат в таблице. Nvidia явно продвигает идею «полного AI-стека», где железо и софт идут парой: модель обучали и оптимизировали под собственные форматы и ускорители, а затем показывают бенчмарк в агентной среде, где throughput и память решают не меньше, чем качество ответов.
У линейки Nemotron 3 компания прямо называет три уровня: Nano, Super и Ultra. Параллельно Nvidia упоминала Nemotron 3 Nano Omni, где заявляет 9x прирост throughput для агентных сценариев.
Первую публикацию результатов компания сделала через свой публичный аккаунт NVIDIA AI: пост NVIDIAAI с бенчмарками Nemotron 3 Super.
















