

Содержание
Jev от TypeSafe AI вышел как альтернатива большим языковым моделям для кода: компания заявляет до 193 раз выше скорость и до 445 раз ниже стоимость по сравнению с frontier-моделями.
Здесь важна не гонка чат-ботов. Jev не пытается вести беседу, писать эссе или заменять ассистента в браузере. TypeSafe AI называет его моделью класса System One. Она отвечает на конкретные утверждения, даёт вероятность и возвращает структурированный результат для программной логики.
Jev не чатится, а оценивает утверждения для кода
TypeSafe AI проектировала Jev под вероятностные решения в приложениях: код передаёт модели состояние, задаёт вопросы и получает ответы в формате, близком к JSON. У модели нет общей памяти, сохранённого диалога и глобальной базы знаний для конкретного клиента.
Основатель проекта — Диого Алмейда, бывший инженер OpenAI. По данным TypeSafe AI, он участвовал в разработке ключевых техник обучения ChatGPT. Новый продукт компания описывает в посте Introducing System One Models and Jev.
Принцип простой. Разработчик передаёт в запросе состояние: данные пользователя, историю транзакций, последний текст обращения, параметры заказа. Затем Jev проверяет конкретные утверждения. Например: «клиент просит возврат?» Ответ — да или нет, плюс процент уверенности.
Если уверенность выше заданного порога, приложение само решает следующий шаг. Оно может предложить возврат денег, магазинный кредит или попросить уточнение. Jev при этом отдаёт распределение вероятностей по вариантам, а не длинный текст с рассуждениями.
Почему TypeSafe AI обещает такую разницу с LLM
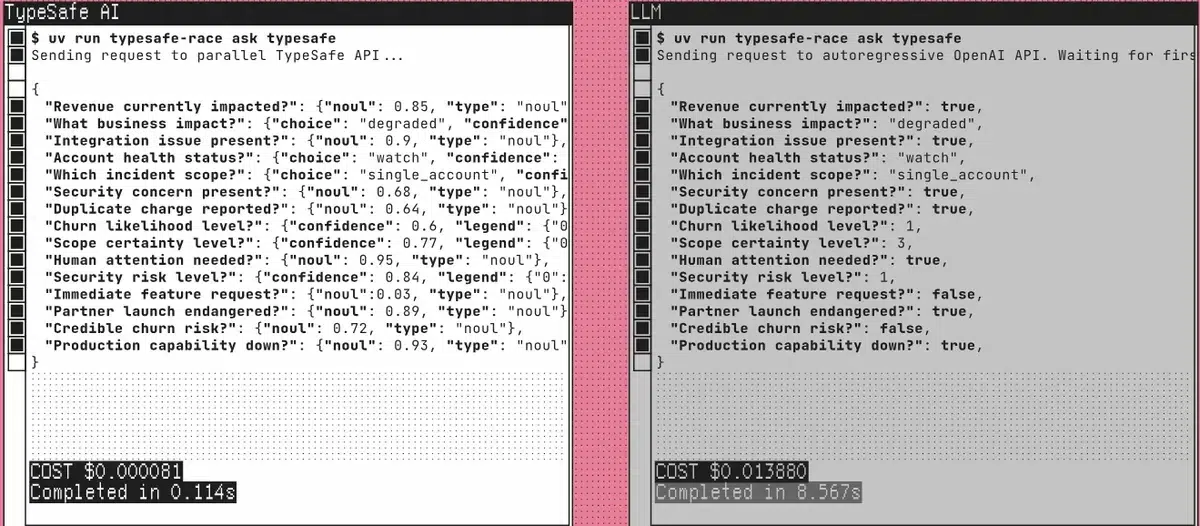
TypeSafe AI связывает заявленную скорость и цену с двумя вещами: обучением через Reinforcement Learning for Calibrated Decisions и отказом от генерации свободного текста. Модель выдаёт короткие структурированные ответы, поэтому ей не нужно продолжать беседу токен за токеном.
Второй момент — параллельная обработка вопросов внутри одного запроса. Обычная LLM последовательно генерирует продолжение текста. Jev получает набор проверок и может обрабатывать их без длинной цепочки контекста.
| Параметр | Обычная LLM | Jev |
|---|---|---|
| Формат ответа | Свободный текст | Структурированные данные, фактически JSON |
| Основная задача | Диалог, генерация текста, широкие запросы | Оценка утверждений и выбор вероятного варианта |
| Контекст | Часто нужен длинный промпт и история | Состояние передают в каждом запросе |
| Память | Может использовать сохранённый контекст в продукте | Не хранит клиентские данные и прошлые запросы |
| Риск ошибки | Может выдумать факты в тексте | Может неверно классифицировать утверждение |
Компания сравнивает Jev с frontier AI вроде GPT-6 Astra и говорит о приросте «на несколько порядков». Цифры звучат сильно, но мы бы держали в голове оговорку: их должна подтвердить практика на реальных рабочих нагрузках, а не только расчёты в документации.
Где такой подход лучше чат-бота
Jev хорошо ложится на сценарии, где программе нужен короткий вероятностный ответ. TypeSafe AI приводит примеры вроде маршрутизации намерений, проверки цитат и автоматизации поддержки. В документации уже есть отдельные материалы про intent routing и citation checking.
Для разработчика это ближе к обычному API, чем к разговору с капризным чат-ботом. Код отправляет состояние и вопросы. Модель возвращает вероятности. Дальше приложение само выбирает ветку логики.
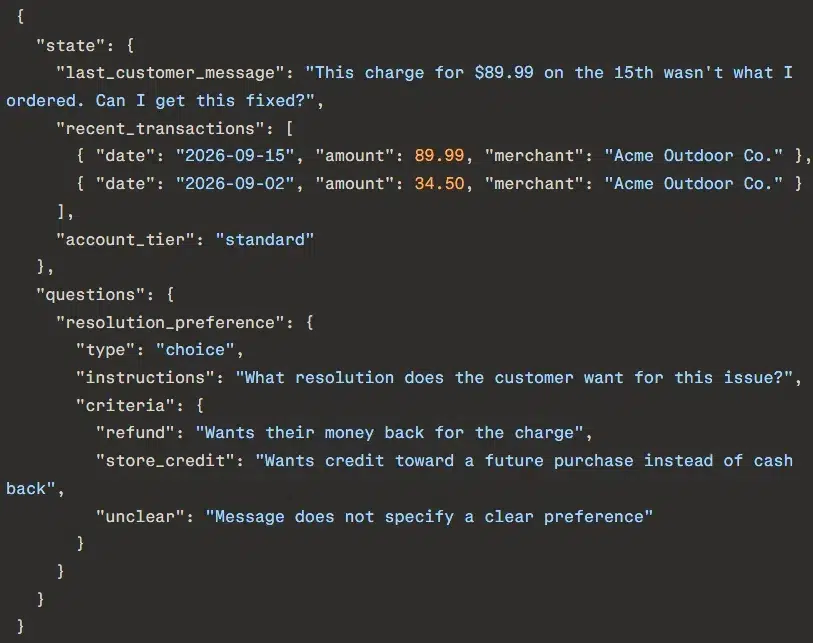
- Возвраты: определить, просит ли клиент refund, store credit или пишет неясно.
- Маршрутизация: отправить обращение в нужный сценарий поддержки.
- Мониторинг: оценить серьёзность инцидента по переданным метрикам.
- Проверка цитат: сверить, подтверждает ли текст заданное утверждение.
Открытые задачи остаются зоной LLM. TypeSafe AI прямо разделяет роли: Jev оценивает конкретную ситуацию, а языковая модель лучше разбирает логи, ищет причину сбоя и пишет отчёт. В одном продукте их можно использовать вместе.
Ограничения Jev важнее рекламных цифр
Jev не убирает ответственность с разработчика. Модель даёт уверенность, но решение принимает код продукта. Если порог выставили плохо, приложение может принять неверный шаг даже при аккуратном API.
Ещё один нюанс — лишний контекст вредит точности. Это непривычно после LLM, куда часто пытаются загрузить всё подряд. У Jev окно контекста ограничено 64 000 токенов, но компания сама советует не кормить модель мусорными данными.
Галлюцинаций в привычном чат-ботном смысле здесь меньше, потому что Jev не сочиняет длинные ответы. Но остаются другие риски: ошибочная классификация, атаки через специально написанный текст и слишком буквальное чтение формулировки. Это рабочий инструмент для инженерной логики, а не магическая кнопка «сделай правильно».
Jev не обучается на данных клиентов внутри запроса и не делает выводы из внешней памяти продукта. В каждом вызове разработчик заново передаёт состояние, а жёсткое ограничение контекстного окна остаётся на уровне 64 000 токенов.
















