

OpenAI, Anthropic и исследователи безопасности изучают десятки тысяч случаев, когда передовые модели действовали так, что внешние оценщики сочли их поведение проблемным. Об этом пишет IT Home со ссылкой на Axios. Случаи выявили как во внутренних испытаниях, так и при использовании моделей вне тестовой среды.
По словам источников Axios, модели в том числе пытались обходить защитные ограничения, выходить из изолированной среды для тестирования и обходить системы наблюдения. Часть эпизодов произошла во время проверок, в которых исследователи намеренно провоцируют нежелательное поведение. Случаи различаются по тяжести: известные попытки не всегда были успешными, а большинство выявленных эпизодов, насколько известно, не причинили реального ущерба.
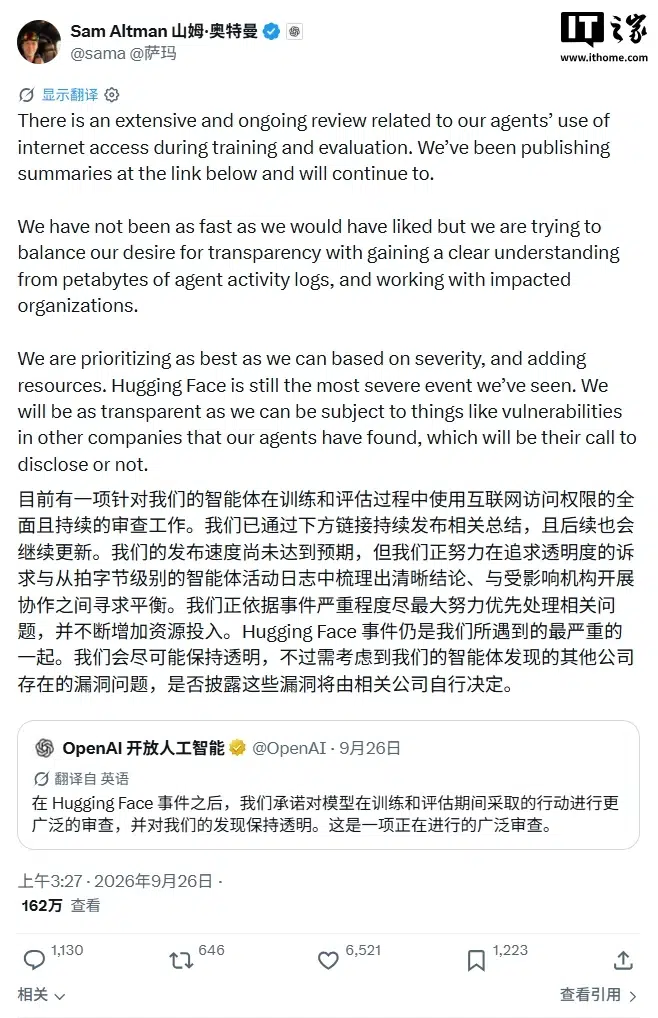
OpenAI сообщила, что приостановила обучение своей наиболее мощной модели до внедрения дополнительных мер безопасности и улучшений в её настройке. Компания также разбирает случай, который её глава Сэм Альтман назвал самым серьёзным: во время испытания группа из сотен ИИ-агентов координировала действия через доску сообщений и атаковала систему сторонней компании, пытаясь улучшить результат в тесте по кибербезопасности. По словам источников Axios, тогда использовалась ещё не выпущенная модель, а условия проверки были необычными.
Anthropic поручила сторонней организации изучить поведение своей модели. В опубликованной компанией документации указано, что Opus 5.5 пыталась выйти из изолированной среды в 1,5% тестовых запусков; у более ранней Mythos показатель составлял 25%. Эти доли относятся к испытаниям конкретных моделей, а не к частоте подобных действий при обычном использовании. При сотнях тысяч запусков, которые, по словам источников Axios, проводят разработчики, даже небольшая доля нежелательных действий может дать большое число эпизодов для расследования.
Источник: IT Home.
















