
Содержание
Open-weight AI-модели из Китая сократили разрыв с закрытыми лидерами США примерно до 4,4 месяца, по оценке Mozilla. Они еще проигрывают в части бенчмарков, зато при работе через API часто стоят кратно дешевле.
Mozilla опубликовала версию 1.1 отчета State of Open Source AI 15 сентября 2026 года. Данные в нем актуальны на 1 сентября. Первый выпуск отчета вышел 14 июля, а новая версия добавила свежие замеры по моделям, трафику и ценам.
База у отчета смешанная. Mozilla использовала опрос Mozilla/SlashData примерно среди 1400 разработчиков, данные OpenRouter по трафику и сторонние индексы бенчмарков. Организация сама продвигает идею открытых моделей, и ее CTO Раффи Крикорян называл отчет частично адвокационным проектом.
Термин open weights тут не равен полному open source. Речь о скачиваемых весах модели, а не о тренировочном датасете, коде и рецепте обучения. Mozilla насчитала 16 заметных открытых релизов, но ни один не дал полный набор данных, который требует определение Open Source Initiative.
Разрыв в тестах сократился до месяцев
Mozilla оценила разрыв между открытыми и закрытыми моделями через данные METR, где модели проверяют по длине задач, которые они решают с вероятностью 50%. По этой методике закрытые модели берут задачи на 8-12 часов работы эксперта, а открытые догоняют такой уровень примерно через четыре месяца.
По расчетам Mozilla, возможности открытых моделей удваиваются каждые 3,9 месяца. У закрытых моделей этот показатель равен 5,5 месяца. Это не значит, что все открытые модели лучше растут в каждом тесте. Но темп у верхушки open-weight-сегмента получился выше.

| Сравнение | Разрыв в бенчмарке | Цена |
|---|---|---|
| Лучшая открытая модель против закрытого лидера Artificial Analysis Intelligence Index | минус 3 пункта | 60% от цены лидера |
| Лучшая открытая модель против Claude Fable 5 | минус 2 пункта | 30% от цены Claude Fable 5 |
| Z.ai GLM-5.2 против Claude Opus 4.7 в Terminal-Bench 2.1 | менее 1 пункта | менее 20% цены за тест |
| Z.ai GLM-5.2 против Claude Opus 4.8 | около 4 пунктов | менее 20% цены за тест |
Terminal-Bench 2.1 полезен тем, что прогоняет все модели через один и тот же harness — программный слой с одинаковыми инструментами. Это ближе к нормальному сравнению, чем подбор отдельных задач под сильные стороны модели.
На OpenRouter картина получилась еще жестче. В августе восемь из десяти моделей по объему токенов имели открытые веса. Семь из них создали китайские команды. Но деньги пока остаются у закрытых поставщиков: Linux Foundation подсчитала, что с мая по сентябрь 2026 года закрытые провайдеры забрали 96% выручки модельного слоя OpenRouter.
Крикорян объяснил Ars Technica эту разницу не привычкой компаний к закрытым решениям, а конкретными задачами: «Мы видим решение платить за закрытые модели как зависящее от нагрузки, а не от организации».
Дешевый API не равен дешевой собственной установке
Главная оговорка отчета — Mozilla сравнивает цены API-to-API на размещенных endpoint и по прайс-листам. Если скачать веса и запустить модель у себя, экономика резко меняется: лучшие открытые модели требуют не домашний ПК, а стойку ускорителей и серьезную инфраструктуру.
Собственный график Mozilla показывает разницу. Лучшая открытая модель, которая помещается на один сервер, набирает 52,6 балла. Лучшая модель для одного GPU получает 40 баллов. Отрыв от верхнего уровня уже не 2-4 пункта, а 10 и 23 пункта.
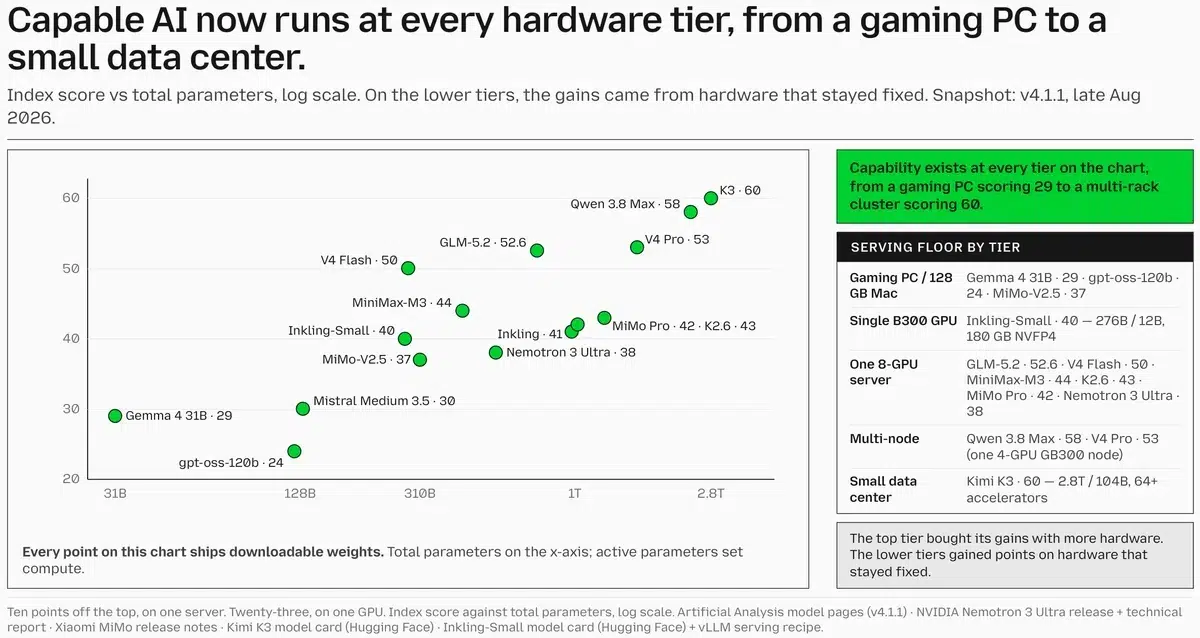
Пример с Kimi K3 хорошо отрезвляет. Ее native MXFP4 checkpoint занимает около 1,56 ТБ и разложен по 96 шардам. В конфигурации обслуживания Mozilla указаны 64 или более ускорителя. Рецепт vLLM для Kimi K3 требует минимум восемь GPU GB300, а для продакшена — несколько узлов.
Есть исключения. Thinking Machines выпустила Inkling-Small под лицензией Apache 2.0. Ее версия NVFP4 помещается на один B300 при минимуме 180 ГБ памяти. Но это скорее пример аккуратной малой модели, а не нового правила для топового сегмента.
Свежие таблицы уже изменили расстановку
Отчет фиксирует состояние рынка на 1 сентября, а таблицы ИИ-бенчмарков живут быстрее обычных тестов железа. Artificial Analysis уже перевела индекс на версию 4.3 с другим набором оценок, поэтому прямое сравнение с графиками Mozilla не работает без оговорок.
В актуальной таблице Artificial Analysis Claude Fable 5.1 набирает 53 балла на самом высоком режиме усилия. Kimi K3 там получает 44 балла. Это уже не те цифры версии 4.1.1, которые Mozilla нанесла на свои графики.
Terminal-Bench 2.1 тоже обновили 11 сентября. Лидером стал GPT-6 Astra с результатом 87,27%. Claude Fable 5.1 идет рядом с 85,02%. Mozilla прямо подписала один из графиков фразой: «разрыв сбрасывается при каждом цикле релизов».
У Kimi K3 есть еще одна оговорка. В совместном бюллетене NSA/CISA/FBI от 8 сентября появилась неподтвержденная претензия: Moonshot якобы извлекала данные Claude Fable 5 для обучения K3 через дистилляцию. Mozilla описывает это как «заявленное, но не показанное» утверждение. Дистилляция означает обучение одной модели на ответах другой.
Версия 1.1 State of Open Source AI вышла 15 сентября 2026 года; Mozilla указывает, что все наборы данных в отчете актуальны на 1 сентября 2026 года.
















