Nvidia расширила возможности DGX Spark: теперь в кластер можно вручную объединить до восьми устройств вместо прежних четырёх. Если использовать модели со 128 ГБ памяти, её суммарный объём в таком кластере достигнет 1 ТБ, сообщает IT Home. Речь идёт о сумме памяти восьми систем, а не об объёме памяти одного DGX Spark.
Для работы с локальными ИИ-моделями Nvidia планирует позднее в октябре выпустить Sync Model Launcher. Инструмент поможет загружать модели и контейнеры под конкретную конфигурацию оборудования и подключать модели к OpenCode. Поддержка восьми устройств пока требует ручной настройки кластера.

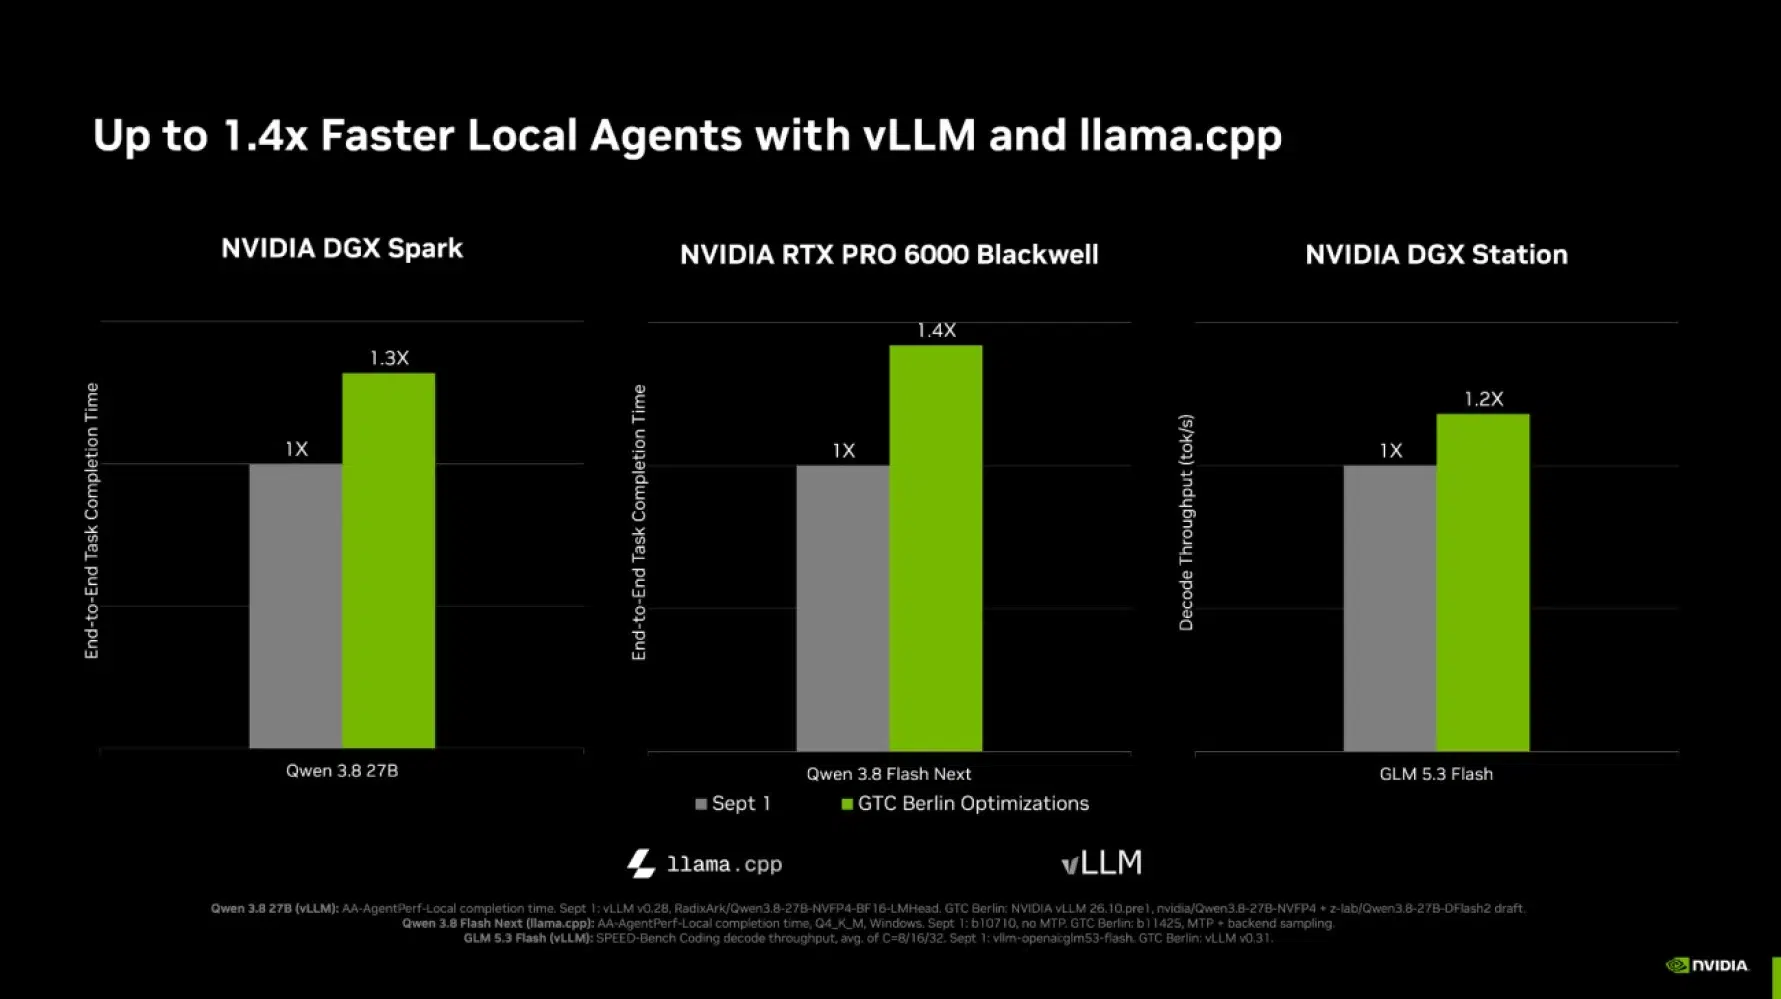
Компания также сообщила об оптимизациях для llama.cpp и vLLM. По данным Nvidia, в задачах с ИИ-агентами на RTX PRO 6000 Blackwell ускорение достигает 40% при работе с Qwen 3.8 Flash Next в llama.cpp. Для DGX Spark компания заявляет ускорение соответствующих задач в vLLM до 30%, а для DGX Station — рост пропускной способности при работе с GLM 5.3 Flash до 20%. Эти цифры относятся к разным моделям и задачам, поэтому напрямую сравнивать скорость устройств по ним нельзя.
Источник: IT Home.