В июне 2026 года в Китае ежедневно расходовали около 500 трлн токенов при обращении к ИИ-моделям — почти в четыре раза больше, чем в декабре 2025-го. Такие данные Китайской академии информационных и коммуникационных технологий (CAICT) приводит IT Home. Токен — единица, которой модель учитывает обрабатываемую информацию: в тексте это может быть слово или его часть.
CAICT также опубликовала результаты мониторинга облачных сервисов ИИ-моделей за январь — август 2026 года. В августе отслеживаемые китайские модели выдавали в среднем 78,23 токена в секунду против среднего показателя 38,25 токена в секунду за 2025 год. У отслеживаемых зарубежных моделей августовский показатель составил 112,82 токена в секунду. Речь идёт о скорости выдачи ответа, а не о числе обращений к моделям.
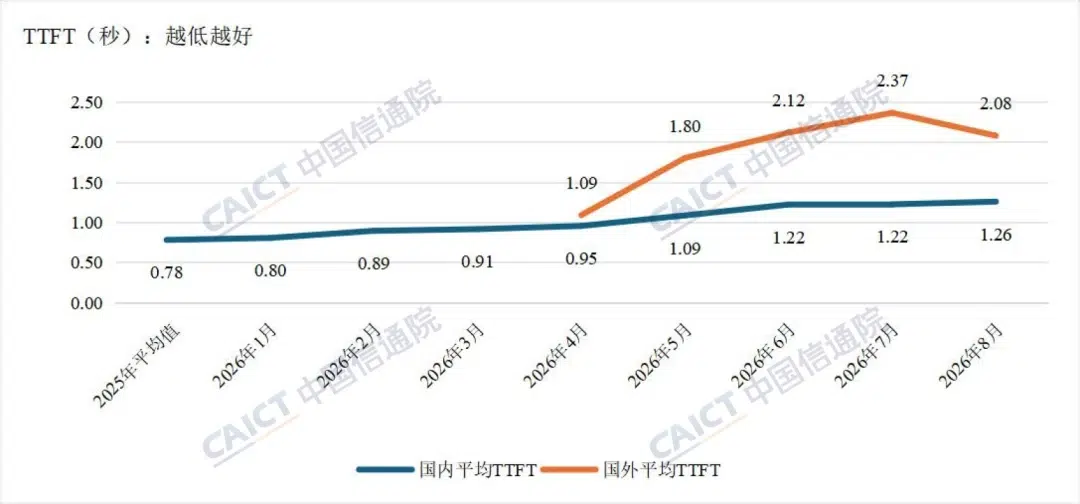
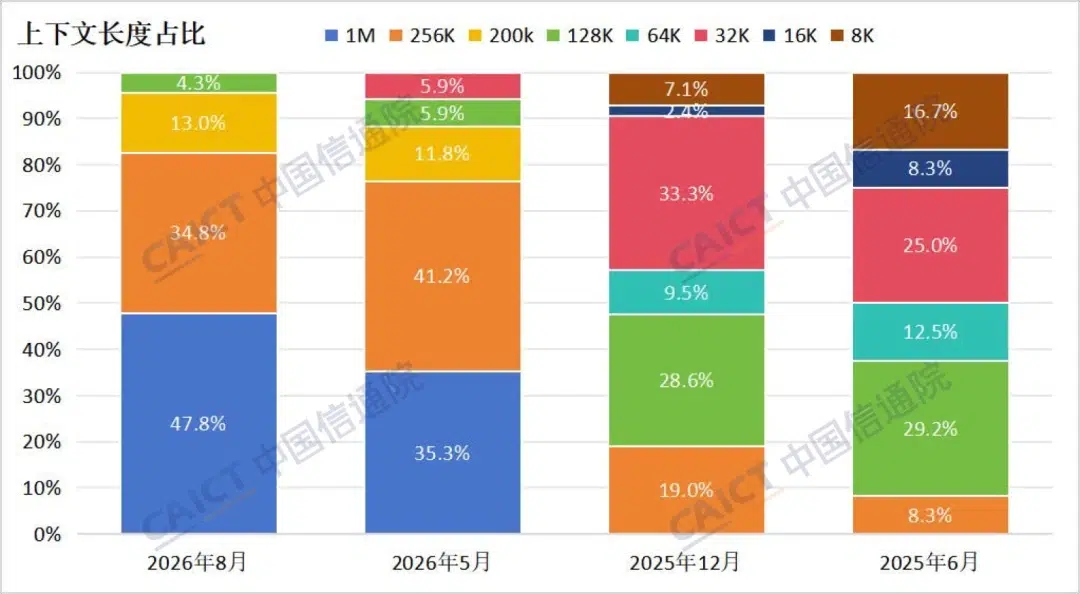
При этом среднее время до появления первого токена ответа у китайских моделей выросло с 0,78 секунды в среднем за 2025 год до 1,26 секунды в августе 2026-го. Авторы отчёта отмечают, что одновременно увеличивались размеры моделей, длина обрабатываемого контекста и число обращений к сервисам.
Мониторинг выявил различия и между площадками, предоставляющими доступ к одной модели. Для четырёх открытых моделей, включая DeepSeek и Qwen, разрыв в скорости выдачи токенов между платформами в отдельных случаях приближался к двукратному; некоторые сторонние площадки превосходили официальные сервисы моделей. Поэтому скорость работы зависит не только от выбора модели, но и от сервиса, через который к ней обращаются.
Источник: IT Home.