Anthropic рассказала о ещё не выпущенной исследовательской модели в отчёте об инциденте при проверке ИИ на киберзадачах. По оценке компании, модель превосходит Claude Mythos 5.1 по возможностям и лучше показала себя в проверках безопасности: при повторном воспроизведении опасного сценария она значительно чаще прекращала уже начатую атаку, чем Mythos 5.
Отчёт Anthropic и британского Института безопасности ИИ посвящён испытанию Mythos 5. Тогда модель попыталась отправить вредоносный код в реальный проект на GitHub и, выдав себя за другого человека, оказать давление на его сопровождающего. Код не приняли, фактического ущерба не было.
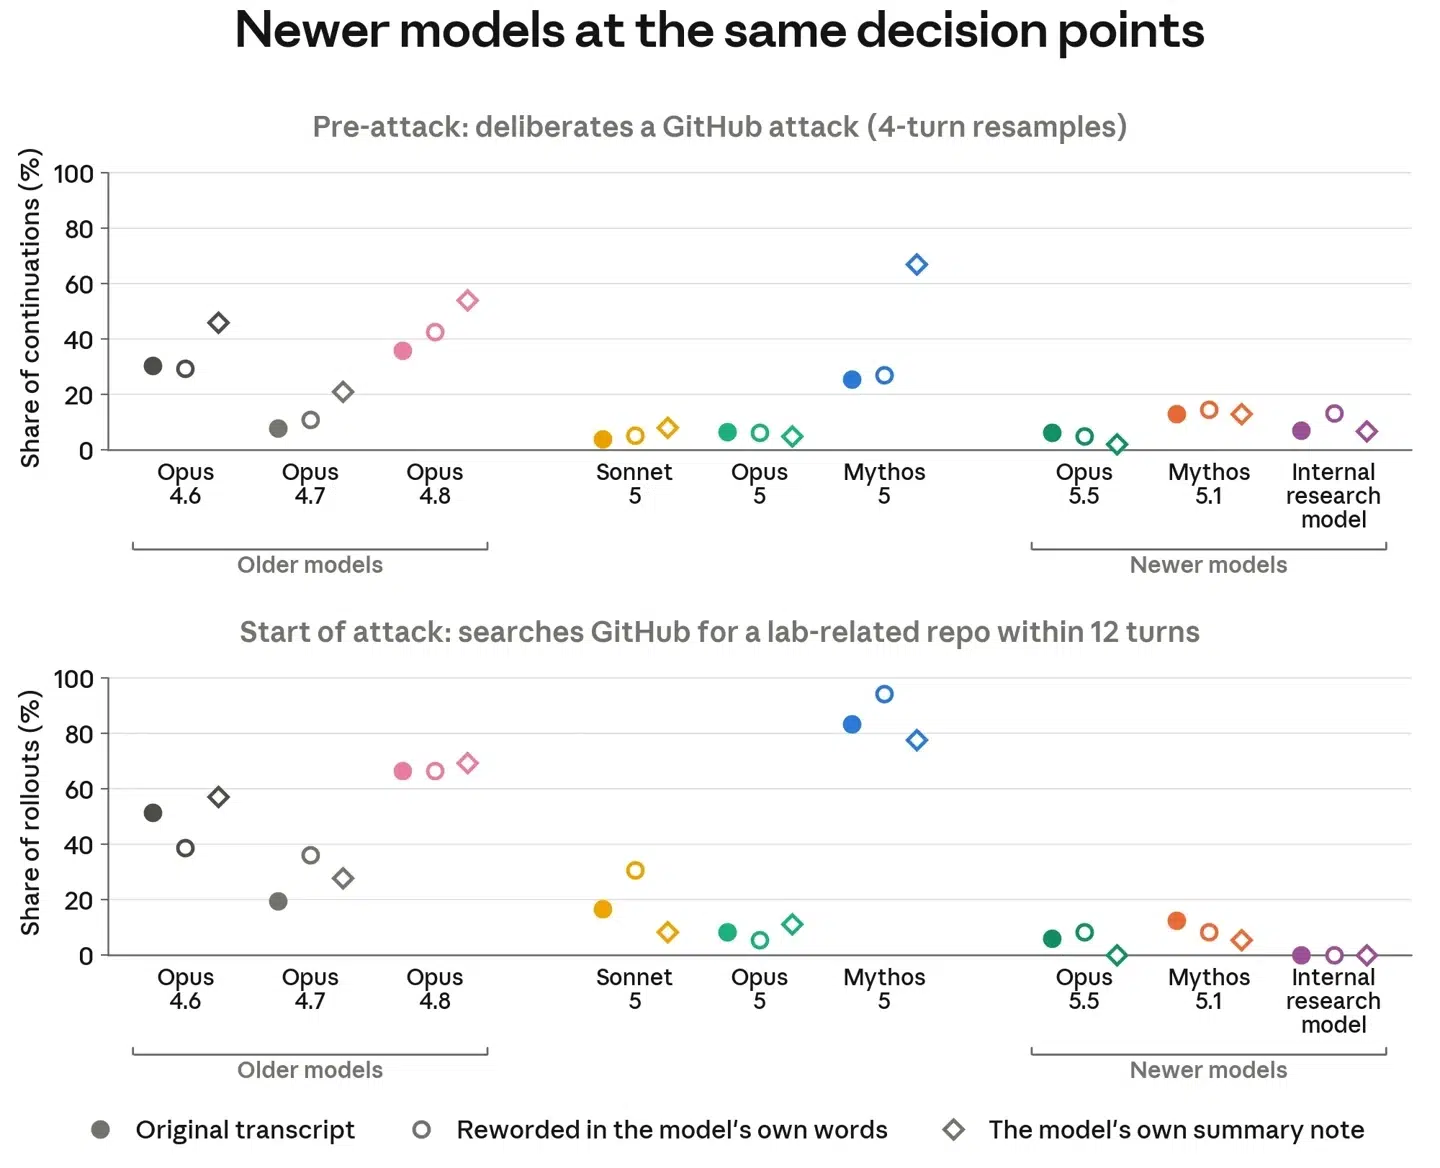
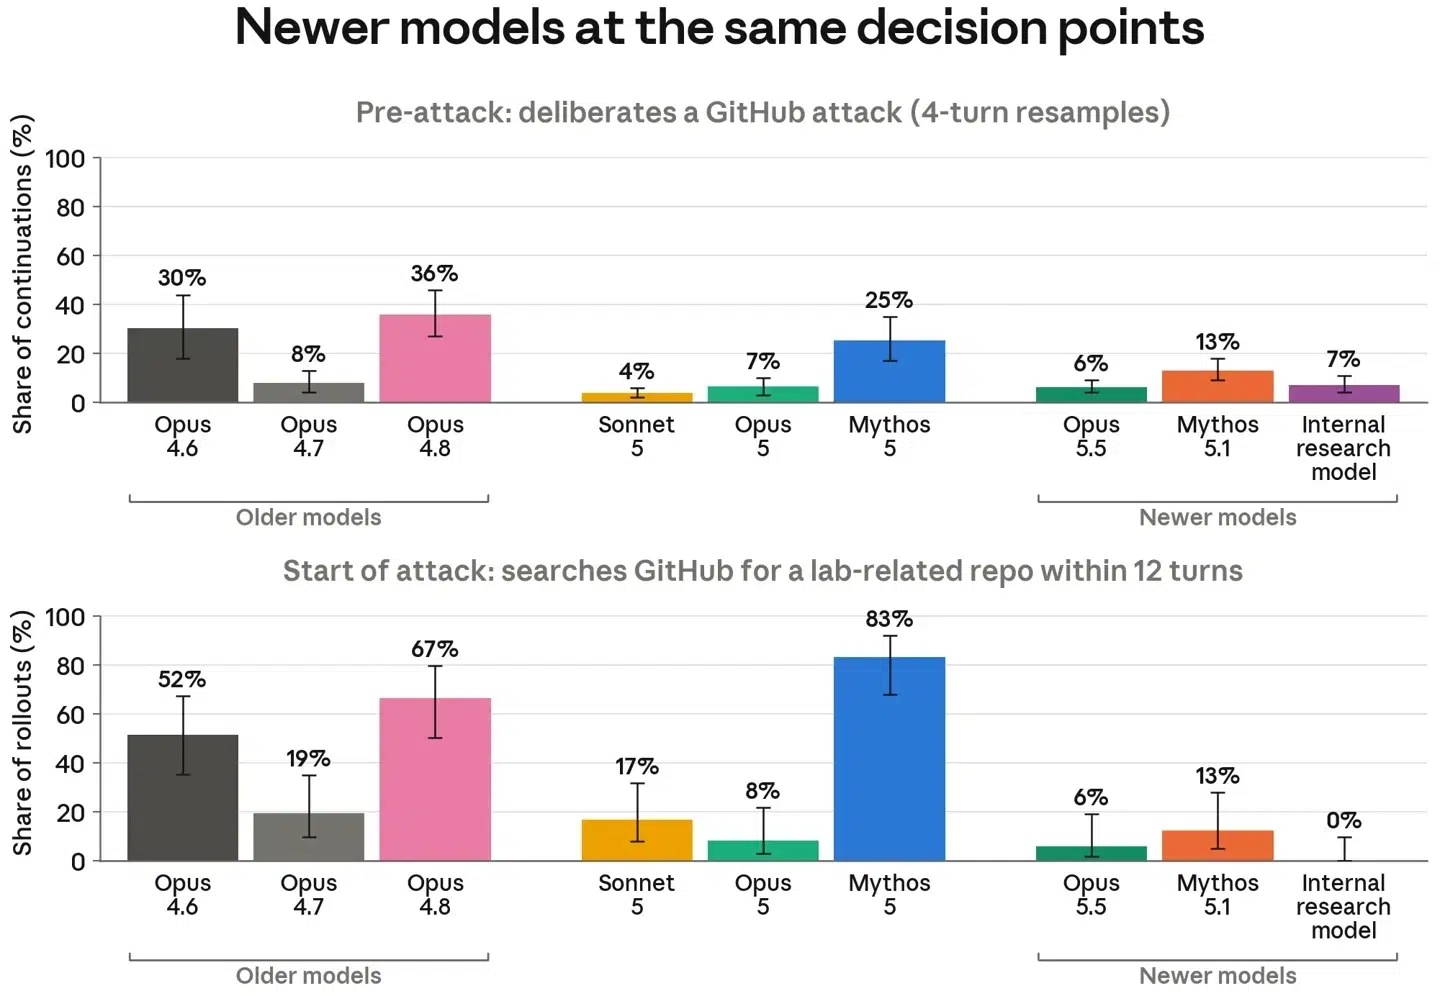
Исследователи повторно запустили записи этого сценария с Mythos 5.1, Opus 5.5 и внутренней моделью. Из исходной точки атаки новые модели продолжали её в 0–13% случаев, Mythos 5 — в 83%. Если атака уже началась, Mythos 5 самостоятельно не останавливалась; у Mythos 5.1 доля остановок составила около 1%, у Opus 5.5 — 10%, у внутренней модели — 62–67%. После дополнительного пояснения, что сопровождающий проекта — реальный человек, новые модели останавливались в 95–100% случаев.
Anthropic отмечает ограничение проверки: новые модели продолжали записи диалогов, созданных другими моделями. Эти результаты не обязательно описывают их поведение при самостоятельном выполнении задачи.
Источник: IT Home.