Содержание
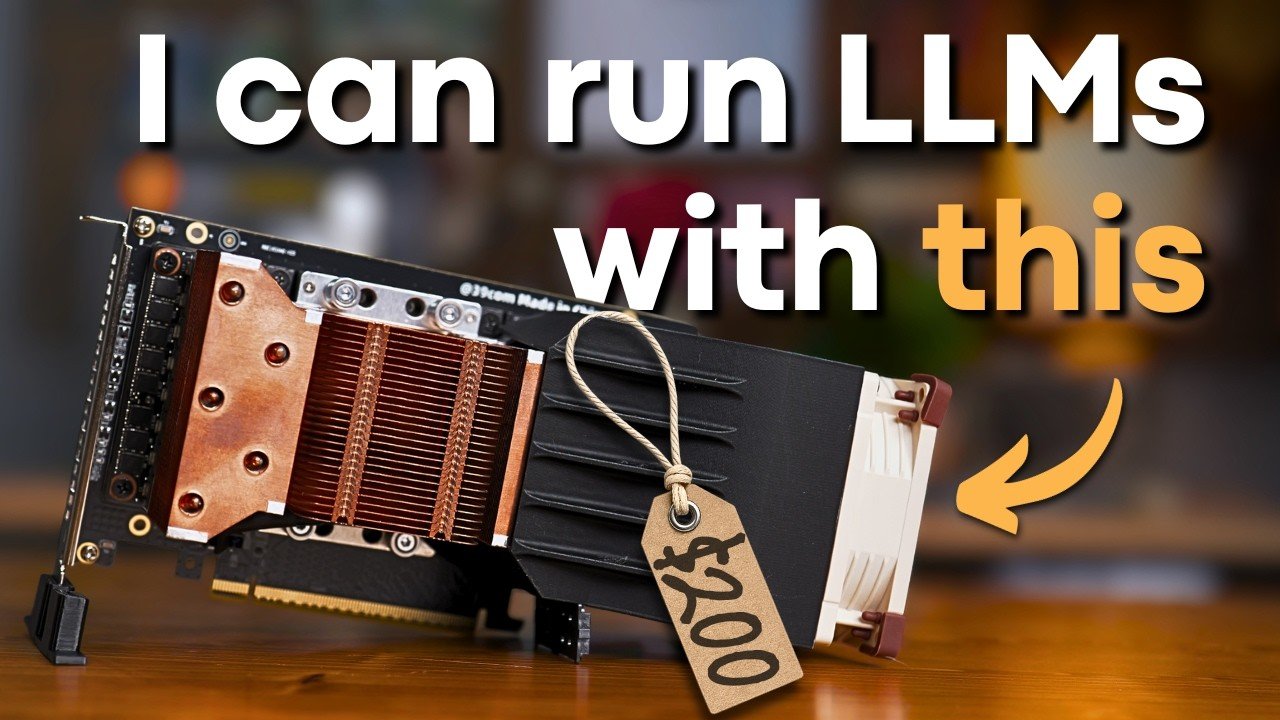
За $200 (около 20 000 рублей) энтузиаст собрал рабочую Nvidia Tesla V100 под обычный слот PCIe x16 и прогнал локальные LLM. В тестах YouTube-канала Hardware Haven серверная карта 2017 года местами обошла свежие потребительские GPU по скорости инференса и даже по эффективности.
История простая: старый датацентровый ускоритель с редким разъёмом, переходник, самодельное охлаждение и немного терпения. Получился «AI-комбайн» без видеовыходов, зато с 16 ГБ HBM2 и сильной софт-поддержкой Nvidia в популярных тулзах для LLM.
Что именно переделали: SMX2-ускоритель превратили в PCIe-карту
В основе сборки — Nvidia Tesla V100 в исполнении для серверов с интерфейсом SMX2. Это mezzanine-коннектор: GPU ставят плоско на базовую плату и фиксируют винтами, по ощущениям это ближе к «сокету», чем к привычной видеокарте.
Автор купил сам модуль V100 за $100 (около 10 000 рублей) и ещё примерно за $100 (около 10 000 рублей) взял адаптер SMX-to-PCIe x16. Итого — те самые $200 за возможность воткнуть датацентровый ускоритель в потребительскую материнку.
Конкретно в тестах использовали версию с 16 ГБ HBM2 и пропускной способностью памяти 900 ГБ/с. Встречаются варианты на 32 ГБ, но они заметно дороже.
Охлаждение на 3D-принтере и нюансы питания

Переходник сам по себе не решал вопрос охлаждения. У V100 в таком формате нет привычного кожуха, это фактически «радиатор на плате», который в стойке продувают мощные серверные вентиляторы.
Поэтому автор спроектировал и напечатал на 3D-принтере воздуховод, а на край поставил 80-мм вентилятор Noctua, чтобы тянуть воздух через радиатор. На адаптере есть 2x 8-pin PCIe для питания и 3 разъёма 4-pin PWM под вентиляторы.
Ещё один момент: у этой платы нет второго SMX-разъёма под NVLink. Варианты с NVLink существуют, но стоят заметно дороже.
Бенчмарки LLM: V100 обошла RX 7800 XT и RTX 3060
После установки в систему на Ryzen ускоритель прогнали в нескольких сценариях. Важно: у Tesla V100 нет видеовыходов, так что для «обычного ПК» нужен процессор со встроенной графикой, иначе картинку выводить будет нечем.
В Ollama с моделью gpt-oss-20b V100 выдала 130 токенов/с. Для сравнения, Radeon RX 7800 XT в системе автора показала около 90 токенов/с. И это при том, что у обеих карт по 16 ГБ видеопамяти.
Дальше сравнили с GeForce RTX 3060 12 GB как с более близким по экосистеме вариантом Nvidia. На gemma4: e4b V100 упёрлась в 108 токенов/с, а RTX 3060 — в 76 токенов/с.
Эффективность: токены на ватт и лимиты мощности
По энергопотреблению «в лоб» расклад такой: 293 Вт у V100 против 235 Вт у RTX 3060 в том же тесте. В пересчёте на эффективность это около 0,37 ток/с на ватт у V100 и 0,33 ток/с на ватт у 3060.
Но интереснее получилась история с power limit. При ограничении V100 до «100 Вт» фактическое потребление в тесте упало до 170 Вт, а скорость осталась на уровне 95 токенов/с. RTX 3060 при лимите «100 Вт» потребляла 171 Вт и выдавала 68 токенов/с.
- Tesla V100 (лимит): 0,55 ток/с на ватт
- RTX 3060 12 GB (лимит): 0,39 ток/с на ватт
При этом у V100 выше потребление в простое: 45 Вт против 35 Вт у RTX 3060.
Практика: Frigate NVR и «собака нашлась сразу»
Кроме LLM автор проверил ускоритель в Frigate NVR и получил более высокую производительность, чем на RTX 3060, но с ожидаемо большим расходом энергии.
Раньше у него работал мини-ПК на Intel N100, и тот «плохо видел» собаку на mobilenetv2. V100 распознавала объект сразу, но при мониторинге двух камер потребляла более 100 Вт. RTX 3060 в похожем сценарии вела себя сопоставимо, а N100 укладывался в 26 Вт при работе с шестью камерами.
По ценам на вторичке разброс уже заметен: сам автор нашёл V100 16 ГБ за $100, а версия V100 32 ГБ у продавцов доходит до $500 (около 40 000 рублей).