Содержание
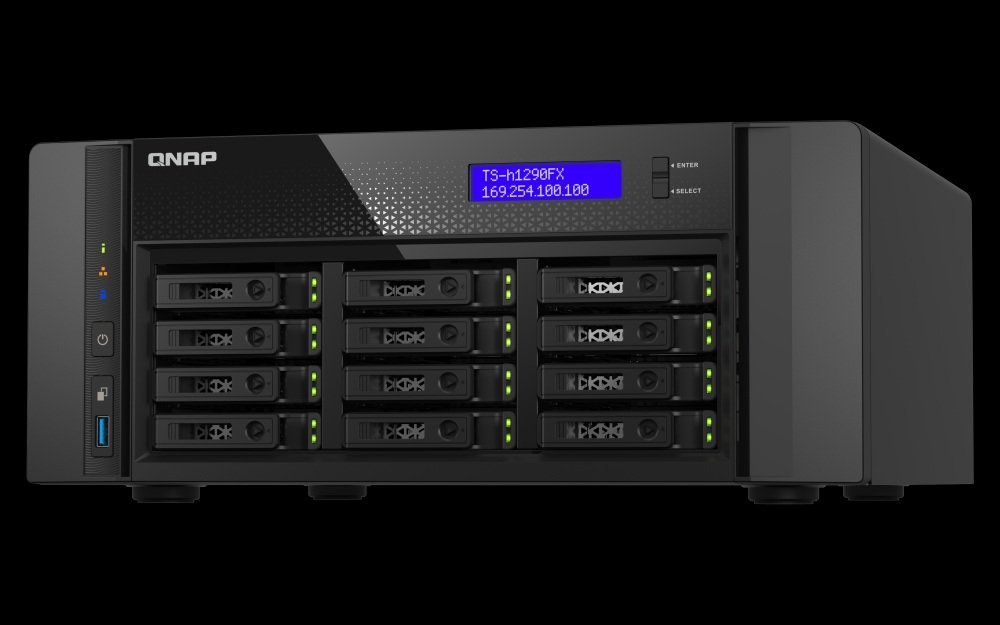
QNAP представила Edge AI NAS QAI-h1290FX для локальных задач LLM, RAG и GenAI. Внутри стоит AMD EPYC 7302P (Zen 2, 16 ядер/32 потока), а в качестве опции компания предлагает видеокарты Blackwell вплоть до NVIDIA RTX PRO 6000 с 96 ГБ VRAM.
Идея простая: хранение данных и инференс рядом с ними, без облака. Это формат для команд, которым важны скорость доступа к датасетам и контроль над чувствительной информацией.
Железо QAI-h1290FX: ставка на GPU, а CPU — проверенный EPYC
Процессор тут не новый, но понятный: EPYC 7302P на Zen 2 даёт 16 ядер и 32 потока. QNAP позиционирует эту связку как достаточную для edge-инференса, а основной ускоритель — дискретная GPU.
По видеокартам есть два варианта. Базовая опция — RTX PRO 4500 Blackwell с 32 ГБ памяти, её QNAP нацеливает на модели до примерно 30B. Старшая конфигурация — RTX PRO 6000 Blackwell с 96 ГБ VRAM, под модели уровня 70B+.
Накопители — тоже часть истории. В корпусе сразу 12 слотов U.2 с поддержкой NVMe и SATA SSD, то есть это all-flash архитектура под высокий I/O при запуске моделей и стриминге данных.
- Накопители: 12 x U.2 NVMe/SATA SSD
- Сеть: 2 x 25GbE + 2 x 2.5GbE
- Расширение: PCIe с поддержкой 100GbE AIC (карты продаются отдельно)
- Масштабирование хранения: совместимость с JBOD-корпусами QNAP
Производительность: до 172 токенов/с на Ollama и тесты vLLM
QNAP приводит замеры для конфигурации с RTX PRO 6000 Blackwell 96 ГБ. В тестах Ollama компания показывает скорость от 24 до 172 токенов в секунду в зависимости от модели и квантизации.
| Модель (режим) | Token/sec | VRAM usage |
|---|---|---|
| gpt-oss:120b (MXFP4) | 90 | ~63GB |
| deepseek-r1:70b (q4_K_M) | 24 | ~41GB |
| qwen3:32b (q4_K_M) | 46 | ~21GB |
| gemma3:27b (q4_K_M) | 54 | ~19GB |
| deepseek-r1:8b (q4_K_M) | 140 | ~7GB |
| qwen3:8b (q4_K_M) | 172 | ~7GB |
Отдельно QNAP публикует результаты конкурентного инференса в vLLM для DeepSeek-R1-Distill-Qwen-7B. Там рост по суммарным токенам заметен до 50 потоков, но средняя скорость на поток ожидаемо падает.
| Модель | Потоки | Total Token/sec | Avg Token/Thread/Sec |
|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-7B | 1 | 79 | 79 |
| DeepSeek-R1-Distill-Qwen-7B | 2 | 166 | 83 |
| DeepSeek-R1-Distill-Qwen-7B | 5 | 410 | 82 |
| DeepSeek-R1-Distill-Qwen-7B | 10 | 688 | 68.8 |
| DeepSeek-R1-Distill-Qwen-7B | 20 | 810 | 40.5 |
| DeepSeek-R1-Distill-Qwen-7B | 50 | 850 | 17 |
Для openai/gpt-oss-20b QNAP тоже показывает vLLM-таблицу. По ней видно, что пик суммарной скорости в этих замерах пришёлся на 5 потоков.
| Модель | Потоки | Total Token/sec | Avg Token/Thread/Sec |
|---|---|---|---|
| gpt-oss-20b | 1 | 218 | 218 |
| gpt-oss-20b | 2 | 340 | 170 |
| gpt-oss-20b | 5 | 1045 | 209 |
| gpt-oss-20b | 10 | 880 | 88 |
| gpt-oss-20b | 20 | 600 | 30 |
Контейнеры, распределение GPU и расширения
QNAP заявляет поддержку Docker и LXD и упор на управление ресурсами GPU без ручной настройки в консоли. Приложения для AI компания собирает в встроенном AI app center, где можно назначать ускоритель под конкретные задачи.
Оперативную память QNAP продаёт отдельно. Варианты — от модулей 8 ГБ DDR4-3200 до комплектов 64 ГБ DDR4-3200.
Страница продукта: QAI-h1290FX на сайте QNAP.
QNAP оценила QAI-h1290FX в $8999 (около 800 000 рублей) за версию с 64 ГБ, $13 499 (около 1 200 000 рублей) за 128 ГБ и $15 999 (около 1 400 000 рублей) за 256 ГБ, гарантия — 5 лет.