14
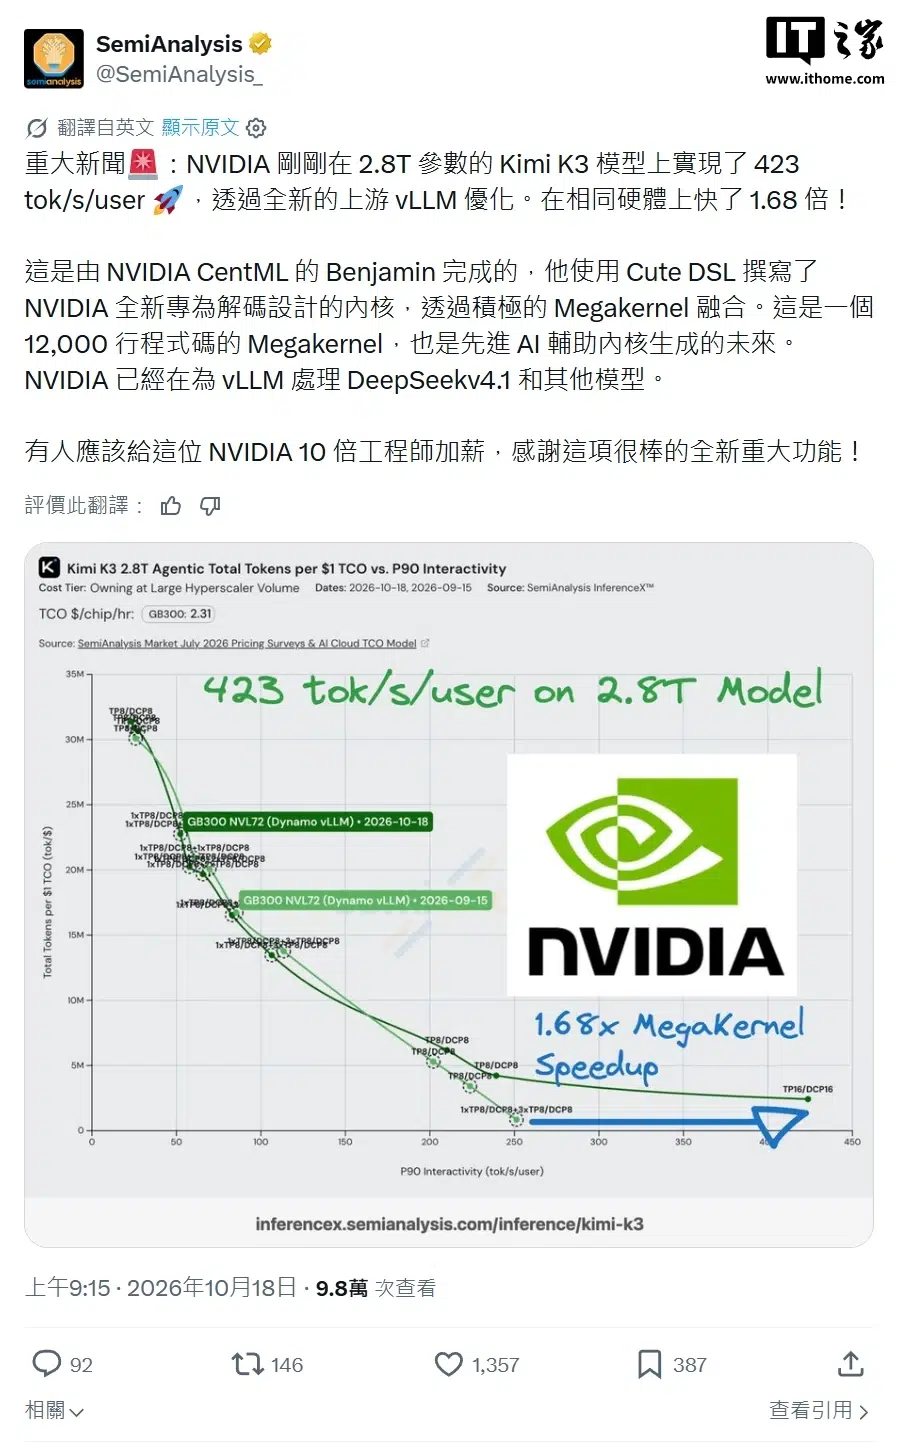
Оптимизация vLLM для модели Kimi K3 повысила скорость генерации до 423 токенов в секунду на пользователя — в 1,68 раза по сравнению с прежним результатом на той же системе GB300 NVL72. Такие данные SemiAnalysis приводит IT Home.
Изменение внесли в vLLM — программную систему для запуска языковых моделей. По сообщению издания, инженер Nvidia CentML Бенджамин объединил операции в крупное вычислительное ядро для генерации ответа и написал его с помощью Cute DSL. Объём этого ядра составляет около 12 тысяч строк кода. Результат относится к Kimi K3 с 2,8 трлн параметров и указанной конфигурации оборудования.
Источник: IT Home.