Команда Alibaba выпустила официальную версию Qwen4-Max — первой модели семейства Qwen4. В отличие от ограниченной по времени предварительной версии, открытой 11 ноября, теперь разработчики могут подключать модель через API или Token Plan. Qwen4-Max принимает изображения и поддерживает контекстное окно до миллиона токенов — объём текста и других данных, которые модель может учитывать в одном запросе.
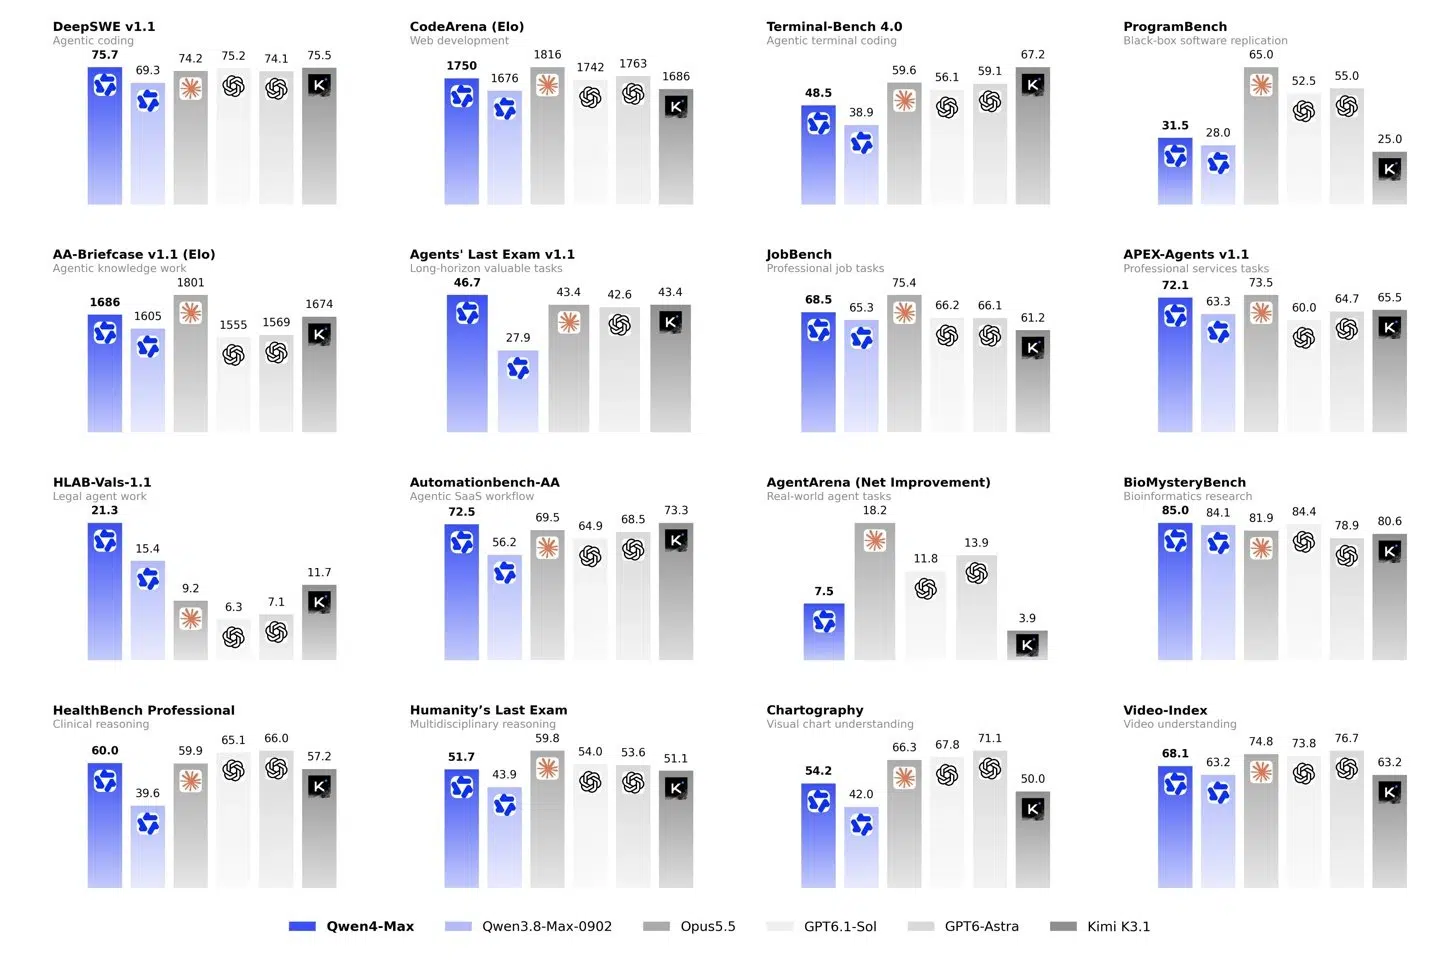
По данным команды Qwen, модель построена на разреженной архитектуре MoE, или «смеси экспертов», и насчитывает 2,4 трлн параметров. Для работы с длинным контекстом в трёх из каждых четырёх слоёв информация о предыдущих токенах сжимается в фиксированное состояние. Четвёртый слой выбирает нужные участки контекста. Такой подход призван сократить вычисления при обработке длинных последовательностей.

В созданном командой Qwen тесте профессиональных задач Work360 новая модель набрала 52,69 балла против 47,74 у Qwen3.8-Max. В этом же тесте средняя стоимость выполнения одной задачи через API снизилась с 26,58 до 11,16 юаня — на 58%. Команда также сообщает, что при сопоставимом качестве Qwen4-Max расходует меньше токенов, чем предшественница: примерно на 24% и 35% в двух режимах интенсивности рассуждения.

API модели доступен на QwenCloud; попробовать её также можно в Qwen Studio, QwenWork и Qoder. Для длительных задач команда представила механизм Live Delivery: модель сначала выдаёт рабочую версию результата, а затем дорабатывает её с учётом обратной связи. Небольшие модели семейства Qwen4 разработчики планируют постепенно выпустить как открытые модели.
Источник: IT Home.