Содержание
DeepSeek V4 вышла с оптимизациями под длинный контекст и триллионные модели, а NVIDIA сразу заявила поддержку на старте для Blackwell. По цифрам компании, один GPU уровня GB300 (Blackwell Ultra) в предварительных замерах выдаёт почти 3500 tokens per second на моделях класса 1,6T.
Ключевой технический крючок тут — упор на низкую точность и ускорение инференса. NVIDIA продвигает стек вокруг NVFP4 и говорит, что это базовая штука для DeepSeek V4 в день релиза.
Что поменялось в DeepSeek V4: меньше FLOPs и меньше KV-cache
DeepSeek V4 получила заметные оптимизации по вычислениям и памяти. В конфигурации с контекстом 1 млн токенов модель использует 27% FLOPs для single-token inference и 10% объёма KV cache по сравнению с прежними требованиями (в терминах самой DeepSeek V4).

Для тех, кто гоняет агентов и длинные цепочки рассуждений, это звучит прозаично, но важно. Упираемся не только в «сырой» TFLOPs, но и в память, а KV-cache при длинном контексте раздувается быстро.
Две версии модели: Pro на 1,6T и Flash на 284B
Одновременно DeepSeek представила две текстовые модели. Обе поддерживают контекст 1M tokens и заявляют максимальную длину выдачи до 384K tokens через API.
| Параметр | DeepSeek-V4-Pro | DeepSeek-V4-Flash |
|---|---|---|
| Модальность | Text | Text |
| Всего параметров | 1.6T | 284B |
| Активные параметры | 49B | 13B |
| Длина контекста | 1M tokens | 1M tokens |
| Макс. длина ответа (по API) | до 384K tokens | до 384K tokens |
| Основные сценарии | Сложное reasoning, кодинг, long-context агенты | Скорость и эффективность, чат, роутинг, суммаризация |
| Лицензия | MIT | Указаны сценарии «high-speed efficiency, chat, routing, summarization» |

Если упростить: Pro — это ставка на «тяжёлую голову» для сложных задач, Flash — на высокую пропускную способность и обслуживание потоков запросов.
Почему NVIDIA делает акцент на Blackwell: FP4, Dynamo и CUDA-ядра
NVIDIA привязала запуск DeepSeek V4 к своему датацентровому железу и софту. Компания перечисляет технологии стека Blackwell, которые заточены под такие модели: NVFP4, Dynamo, оптимизированные CUDA kernels и продвинутые техники параллелизации.
Отдельно NVIDIA подчёркивает роль FP4 (MXFP4) квантизации. По описанию компании, она ускоряет и rollouts, и инференс-проходы, снижает трафик памяти и уменьшает задержку семплирования.
По предварительному слайду с производительностью NVIDIA, один GPU GB300 (Blackwell Ultra) выдаёт почти 3500 TPS. Компания добавляет, что это не финальные результаты, и цифры ещё вырастут по мере оптимизаций «co-design» стека.
Технические детали NVIDIA по запуску и интеграции DeepSeek V4 компания собрала в отдельной заметке: via NVIDIA, а про формат низкой точности — в разборе NVFP4.
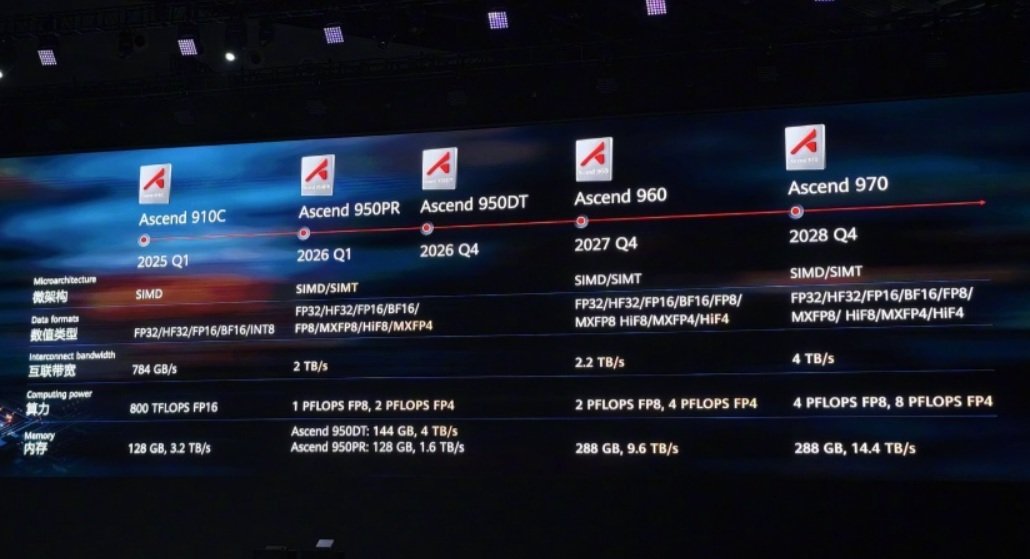
Ещё один факт из релизного контекста: Huawei Ascend 950PR и Ascend 950DT, которые планируют на 2026 год, тоже получат инструкции MXFP4. Это значит, что DeepSeek V4 изначально ориентируется на FP4-экосистему не только у NVIDIA.
Публичный анонс NVIDIA по DeepSeek V4 в соцсетях датирован 24 апреля 2026 (MSK): April 24, 2026.