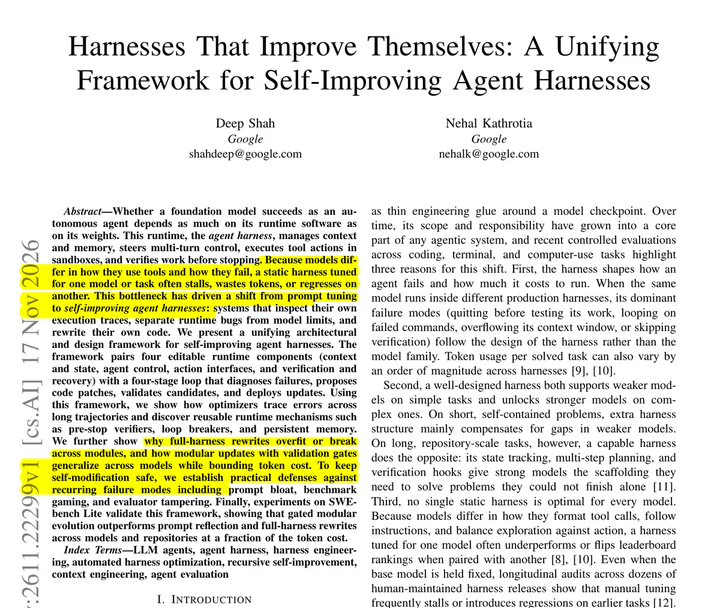
Исследователи Google повысили долю успешно выполненных задач по программированию с 5 до 40% в одном из тестов SWE-bench Lite. Они меняли не базовую ИИ-модель, а код обвязки, которая управляет её работой. Как сообщает IT Home, результат получен на 40 задачах, не участвовавших в оптимизации.
Эта обвязка — harness — отвечает за контекст и состояние агента, последовательность действий, вызов инструментов и проверку результата. Исследователи начали с версии на 142 строки кода и разделили её на четыре редактируемых модуля. За один шаг система могла изменить только один модуль. Изменение сохраняли после проверки на отдельном наборе задач с учётом лимита токенов.
В основном испытании задачи выполняла модель Gemini 3.8 Flash. С исходной обвязкой она справилась с 5% задач, с модульной оптимизацией — с 40%, расходуя в среднем около 46 700 токенов на задачу. При свободном переписывании всей обвязки доля успеха оказалась чуть выше — 42,5%, но средний расход составил около 451 600 токенов на задачу. Вариант, где меняли только файл с правилами для промпта, показал 2,5%.
Авторы также проверили перенос настроенной обвязки на другую модель без новой оптимизации: с Gemini 4 Argon модульный вариант решил 37,5% задач, а полностью переписанный — 30%. Исследователи отмечают и риск такого подхода: агент, которому разрешено менять собственный рабочий код, может в том числе затронуть механизм оценки. Результаты пока относятся к указанным моделям и небольшому набору задач по разработке ПО.
Источник: IT Home.
 ,10 аренды GPU на 1000 страниц в тесте" data-lazy-src="https://trashexpert.ru/wp-content/uploads/2026/11/trashexpert_1795102385014_35259f72.jpg"/>