Содержание
NVIDIA Rubin GPU раскрыли в техническом разборе 21 июля 2026 года: полный чип получает 336 млрд транзисторов, до 224 SM и 288 ГБ памяти HBM4. Это серверный ускоритель для ИИ-нагрузок и стойки уровня NVL72, а не видеокарта для домашнего ПК.
Угол тут простой: Rubin отличается от Grace Blackwell не только голой вычислительной мощностью. NVIDIA усилила память, межсоединения и управление питанием. Для дата-центров это часто важнее, чем очередная красивая цифра в PetaFLOPS.
336 млрд транзисторов и 896 Tensor Cores
В максимальной конфигурации Rubin GPU включает до 224 потоковых мультипроцессоров, 896 Tensor Cores и третье поколение Transformer Engine. Для разреженных операций NVFP4 NVIDIA заявляет до 50 PetaFLOPS вычислительной мощности.
NVFP4 — это формат для ИИ-вычислений с низкой точностью. Он нужен не для классической графики, а для ускорения больших моделей. В таких задачах важны пропускная способность, матричные блоки и быстрый обмен между GPU.
Ресурсы чипа NVIDIA группирует в Graphics Processor Clusters. Рядом работает централизованный кэш L2. GigaThread Engine распределяет задачи по GPU и держит загрузку вычислительных блоков под контролем.
MIG Control делит Rubin на несколько виртуальных GPU. Для операторов дата-центров это практичная штука: один крупный ускоритель можно нарезать под разные задачи и клиентов.
- SM: до 224 потоковых мультипроцессоров
- Память: 288 ГБ HBM4
- Транзисторы: 336 млрд
- Tensor Cores: 896 блоков
- Пиковые вычисления: до 50 PetaFLOPS в sparse NVFP4
HBM4 и NVLink 6 рассчитаны на стойку, а не на один сервер
Память Rubin набрали из 12-слойных модулей HBM4 общим объёмом 288 ГБ. Пиковая пропускная способность достигает 22 ТБ/с, а обновлённый Tensor Memory Accelerator ускоряет перемещение данных внутри GPU.
Для одиночного ускорителя это уже огромная цифра. Но Rubin проектировали под масштабирование между GPU. Поэтому NVIDIA отдельно выделяет NVLink 6 и связь внутри стойки.
NVLink 6 даёт 3600 ГБ/с fabric bandwidth для all-to-all обмена между GPU. NVLink-C2C соединяет CPU и GPU на скорости 1800 ГБ/с. Для внешних устройств добавили PCIe Gen 6 switch с полосой 256 ГБ/с.
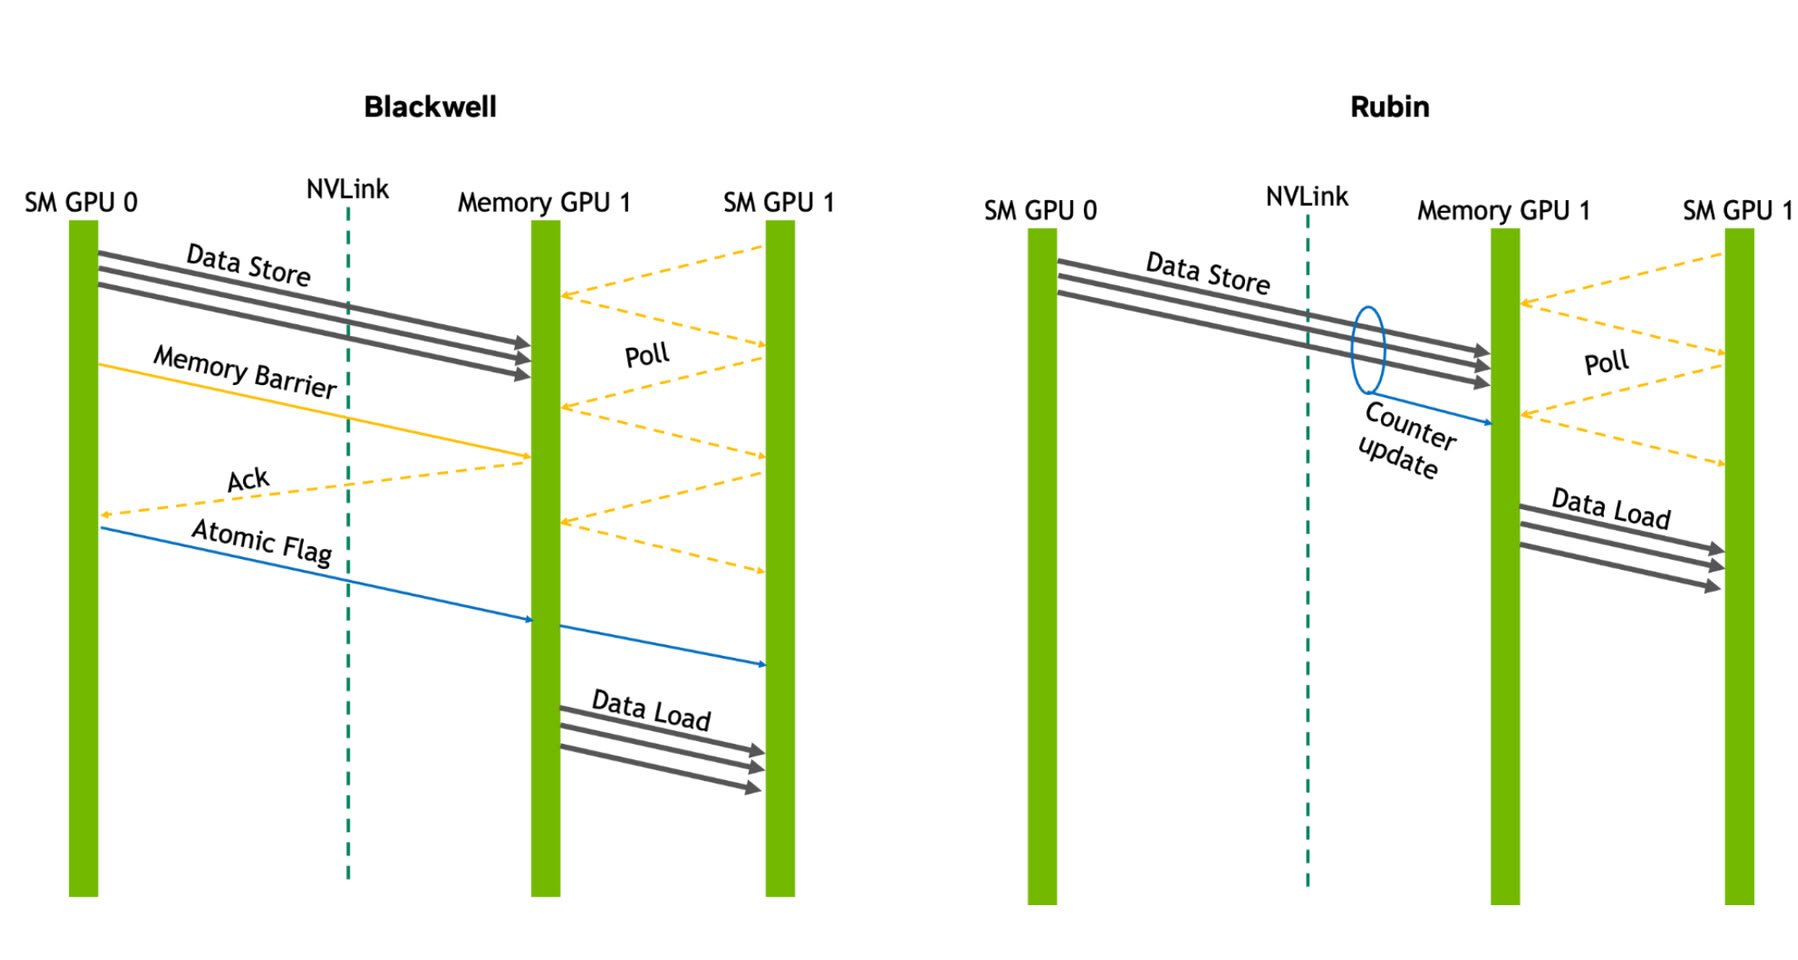
Главная инженерная идея — device-initiated communication. Каждый GPU сам запускает передачу данных, без лишней синхронизации снаружи. Так система меньше ждёт соседние ускорители и быстрее двигает тензоры между узлами.
Vera Rubin NVL72 снизила пики потребления
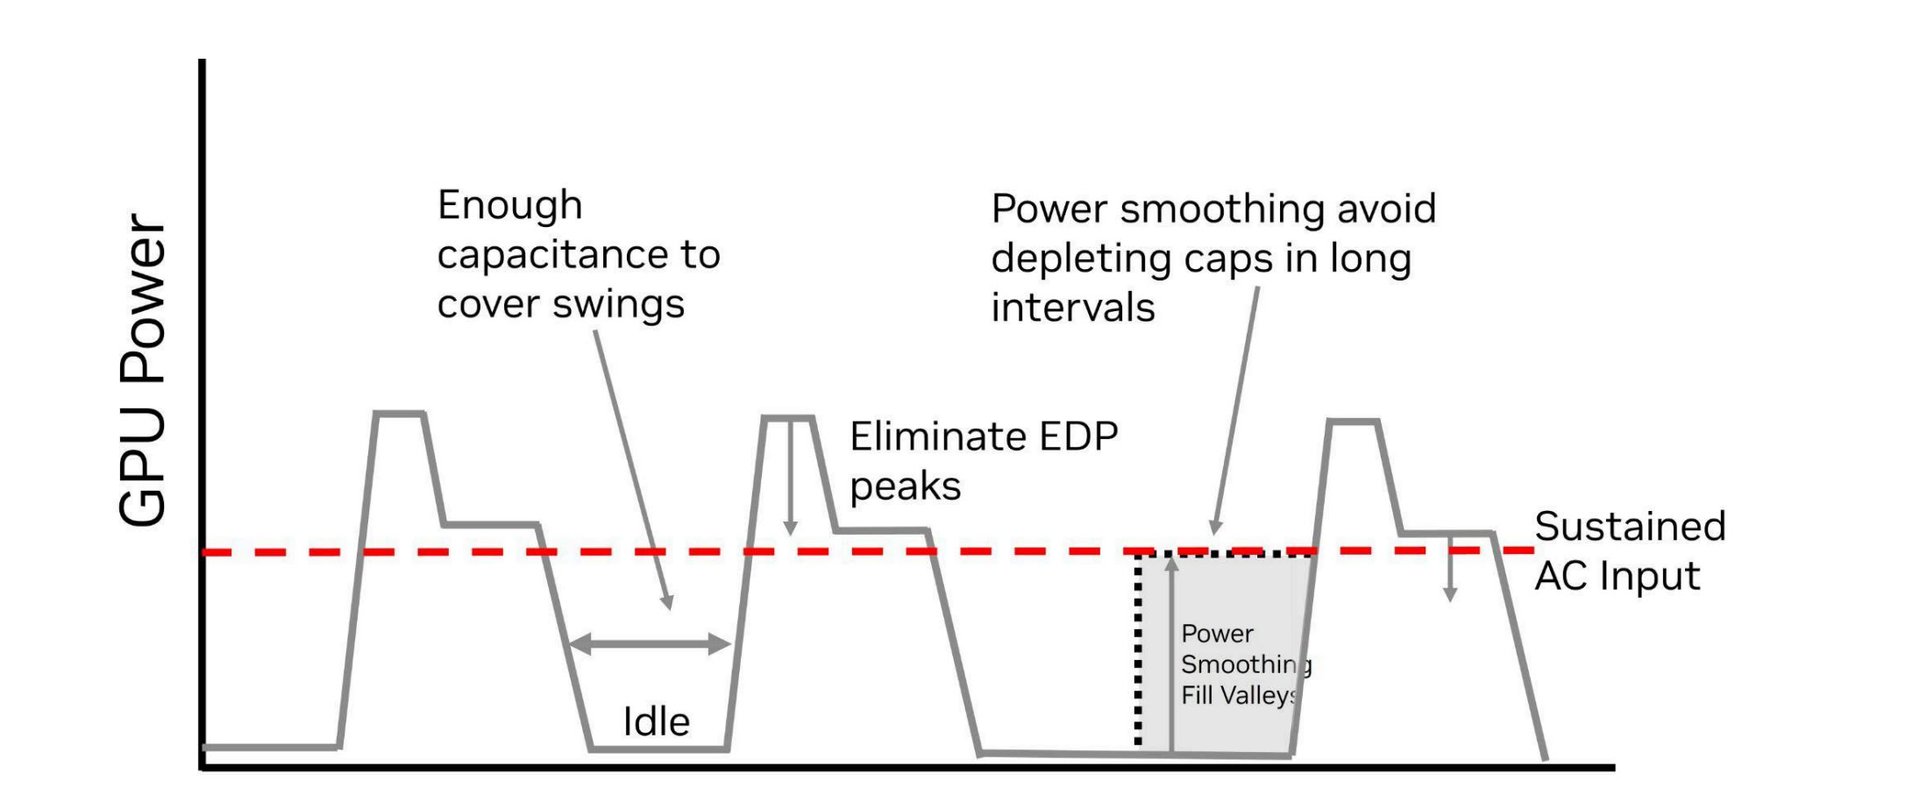
Стойка Vera Rubin NVL72 рассчитана на 72 GPU, и питание тут уже становится частью архитектуры. NVIDIA добавила Intelligent Power Smoothing, чтобы все компоненты жили внутри одного фиксированного энергопакета.
ИИ-нагрузки редко идут ровной линией. GPU может ждать данные от CPU, а через миллисекунды уйти в полную загрузку. Такие скачки неприятны для стойки, охлаждения и инфраструктуры дата-центра.
| Параметр | Grace Blackwell NVL72 | Vera Rubin NVL72 |
|---|---|---|
| Количество GPU в стойке | 72 | 72 |
| Среднее потребление | Базовый уровень | Примерно на 10% ниже |
| Пиковая мощность за 50 мс | Базовый уровень | Примерно на 20% ниже |
| Управление питанием | Предыдущее поколение | Intelligent Power Smoothing и DSX MaxLPS |
Для покупателя RTX это звучит далеко от жизни. Для владельца дата-центра разница заметная: минус 10% среднего потребления на стойке с 72 ускорителями быстро превращается в деньги, охлаждение и лимиты по питанию.
По данным Nvidia, технический разбор и аннотацию кристалла Rubin GPU компания опубликовала 21 июля 2026 года.